Advanced 3D-ICs Physical Design: P&R Algorithms for LogicFolding
本文从传统布局布线算法出发,梳理学术界3DIC物理设计研究的核心问题,分析从2D到3D新增的算法决策因素与约束,讨论相关方法的建模假设和适用边界。审视学术研究中的3DIC问题简化假设与实际工程需求之间的差距,探讨这些方法在工艺适配、设计收敛和工具链集成方面仍需补齐的环节,为评估其工程应用价值提供参考。
一、传统布局布线算法回顾
1.1 布局
1.1.1 Analytical Global Placement
线长和密度是布局问题中最基本的两个优化因素,它们的大体优化趋势相反:
-
线长项希望把cell拉得更近,缩短连线;
-
密度项抑制局部聚集,希望将cell分散到有可用空间的区域。
一般而言,我们希望在满足密度约束(target density)的限制下尽可能的缩短线长。现代解析布局器一般使用基于梯度的方法联合优化线长与密度,会构造如下形式的优化目标:
密度惩罚系数\(\lambda\)控制两个变量作用的相对强度。初期通常给予线长优化较大的自由度,先形成较好的连接关系;\(\lambda\)会随着布局迭代指数级增长,直到后期主导整个优化(加速到达停止条件)。这一过程希望保留线长优化形成的空间关系,同时让布局逐渐接近可行状态。
- 线长(Wirelength)模型
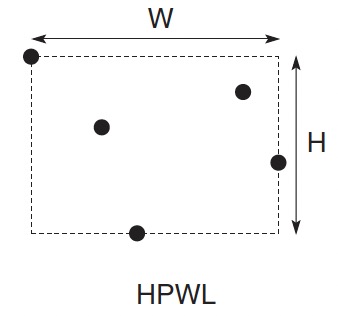
现代解析布局器需要数千次迭代评估线长,半周线长(HPWL)形式简单、计算快,是最常被使用的线长快速评价指标:
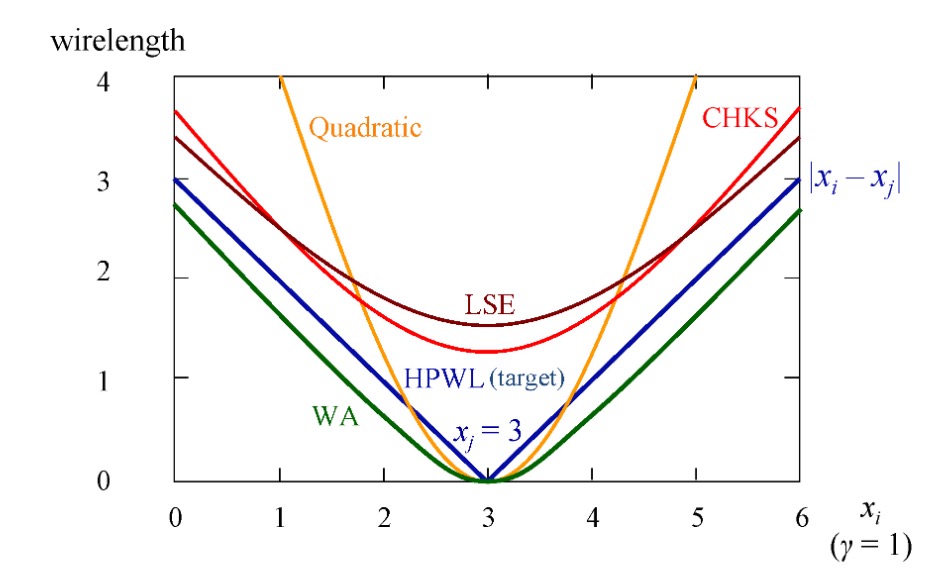
\[\operatorname{HPWL}(x,y) = \max x - \min x + \max y - \min y\]由于存在min和max的计算形式,HPWL在数值中心处存在非光滑的不可微点,这对基于梯度下降实现的解析布局器非常不友好,因此一系列光滑线长模型被设计,用于解决HPWL的非光滑近似。
WA(Weight Average)和LSE(log-sum-exp)是学术界最常用的两种线长模型,他们的主要思想都是使用加和指数项解决HPWL中出现的min/max形式,使HPWL变得处处可微。
线长模型的设计主要考虑两个因素:数值近似/误差和梯度行为。所以一般的线长模型还会存在一个光滑参数,一些布局器会在不同优化阶段根据需求控制线长模型的数值精度和梯度。
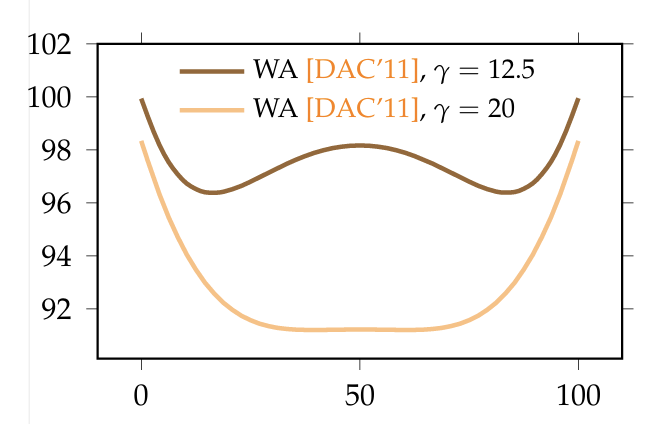
- 密度(Density)模型
线长模型将不光滑函数的不光滑拐点进行近似光滑化,类似的方法早期也直接用于密度光滑建模(bell-shaped函数等方式平滑cell对周围bin的面积贡献),但这样会产生不同网格之间密度的相互干扰,导致最终的解质量受损。密度模型的建模既要反映哪里拥挤,也要提供有效的梯度,指导cell如何分散。
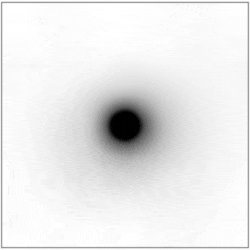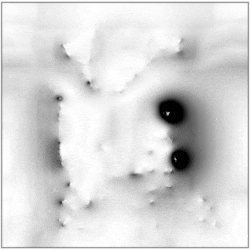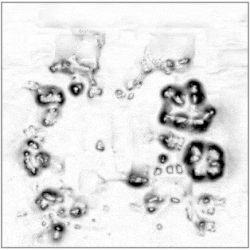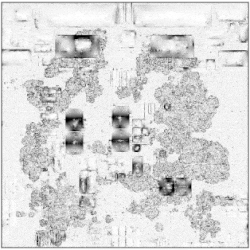
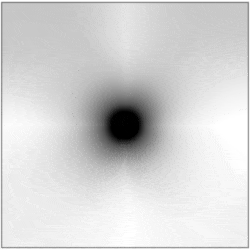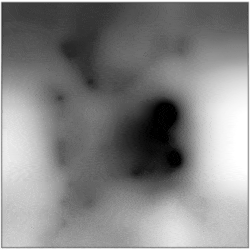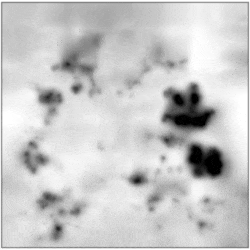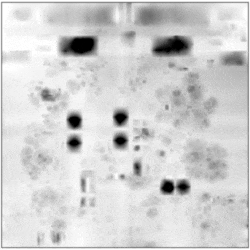
以ePlace为代表的静电密度模型,将cell建模为正电荷,电荷量与面积对应,再将空间占用分布映射为电荷密度。求解时去掉密度的平均分量,使电荷分布表示相对于平均密度的偏差:拥挤区域对应正偏差,稀疏区域对应负偏差。电荷密度、电势和电场通过Poisson方程自然联系起来。密度分布产生电势和电场,电场进一步给出推动cell分散的方向;相应的静电势能构成布局目标中的密度惩罚项。
实际计算中,算法在网格上采用基于FFT的谱方法,通过离散余弦变换(DCT)等方法求解电势和电场。这样,每个cell获得的密度梯度能够反映整个布局区域的密度分布。
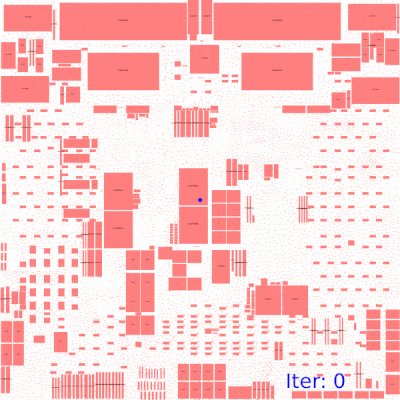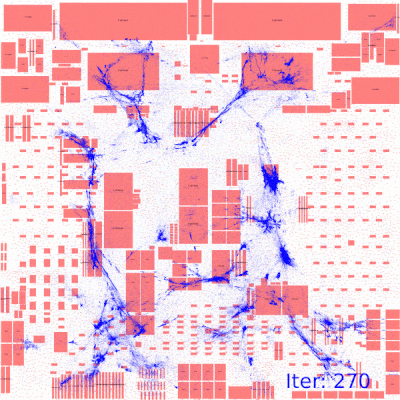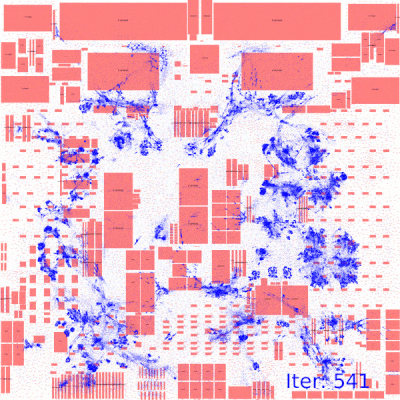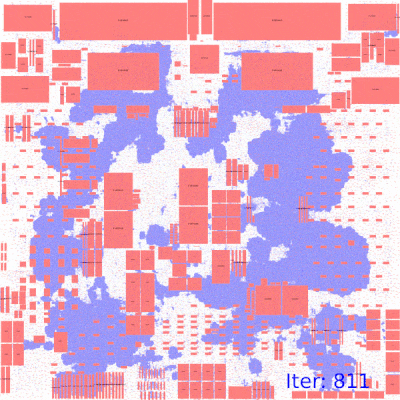
- timing-driven/congestion-driven/thermal-aware……
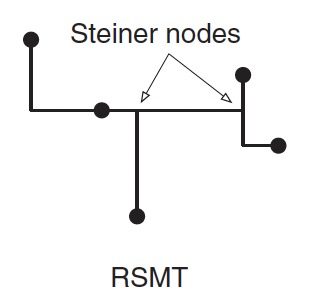
布局问题中使用的HPWL-based线长和实际绕线的RSMT-based线长模型存在较大差异。单纯的线长代理也无法考虑到RC代价、绕线阻塞等下游流程带来的设计风险。
因此还有一类研究尝试在布局时考虑更多细化问题,如timing、congestion、thermal等等
但近些年这些优化基本都是基于Analytical Global Placement的优化指标(设计新的可微优化项)或者已有的线长(Net Weight)、密度建模(adaptive density、cell inflation)上改进。
1.1.2 Detailed Placement
Detailed Placement主要评估离散候选操作带来的代价变化。
常见的优化操作包括:
-
Local Reordering:在一行中选取较小的窗口,尝试改变其中cell的排列顺序,保留代价更好的合法排列。小窗口可以控制排列组合的搜索开销。
-
Global Swap:为cell搜索交换对象,通过成对交换改善线长。搜索可以跨行或超出相邻区域,但交换后仍须满足尺寸、空间和区域等约束。
-
Independent Set Matching:选取一组互不共享net的cell,将它们重新分配到一组兼容位置。固定其他cell后,HPWL代价可以按“cell—候选位置”分别计算,从而构造最小代价二分图匹配问题。
这些方法通过反复优化一小部分cell来改善整体布局。搜索范围越大、参与的cell越多,越可能找到更好的组合,但候选数量和合法性处理的成本也随之增加。因此,实际算法通常组合多种操作,在优化收益与运行时间之间取舍。
1.2 布线 (Global Routing & Detailed Routing)
布线算法的核心目标是:在不违反设计规则(DRC)的前提下,完成所有线网的连接。
直接在完整几何空间中同时求解所有线网的走线成本很高,布线通常分为Global Routing(GR)和Detailed Routing(DR)两个阶段。Global Routing和Detailed Routing的核心算法都是 Pattern Routing (简单连线) + Maze Routing(复杂寻迹) 和 Rip-up and Re-route(解决DRV)。主要区别在于:
-
GR阶段考虑 Grid/GCell 粒度的 Routing guide 绕线和 layer assignment,目标是降低overflow;
-
DR阶段考虑 segment (iroute) 粒度的具体走线路径和 track assignment,直到DRC clean或到达最大迭代次数。
路径搜索方法可以放在Rip-up and Re-route框架中反复调用:先构造连接,再根据资源冲突或设计违例拆除部分走线,并重新搜索,不同工具可能会采用不同组合策略。
1.2.1 Rip-up and Re-route
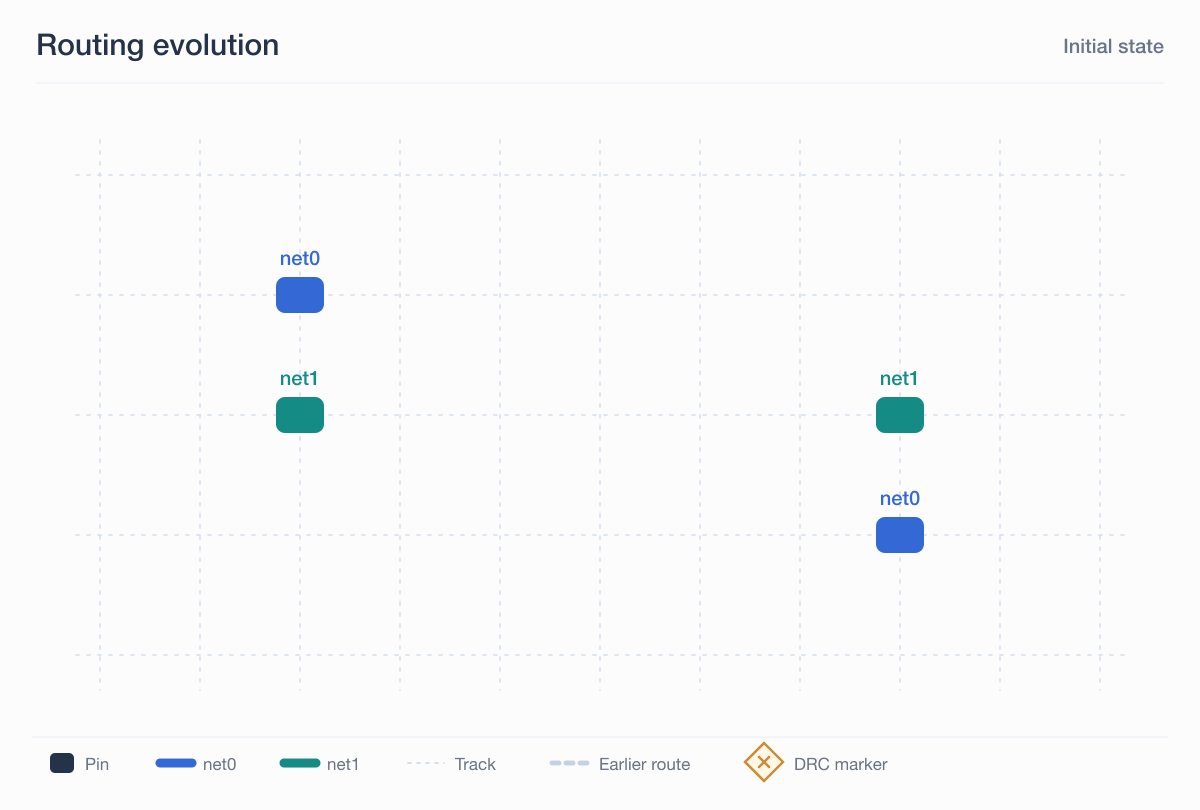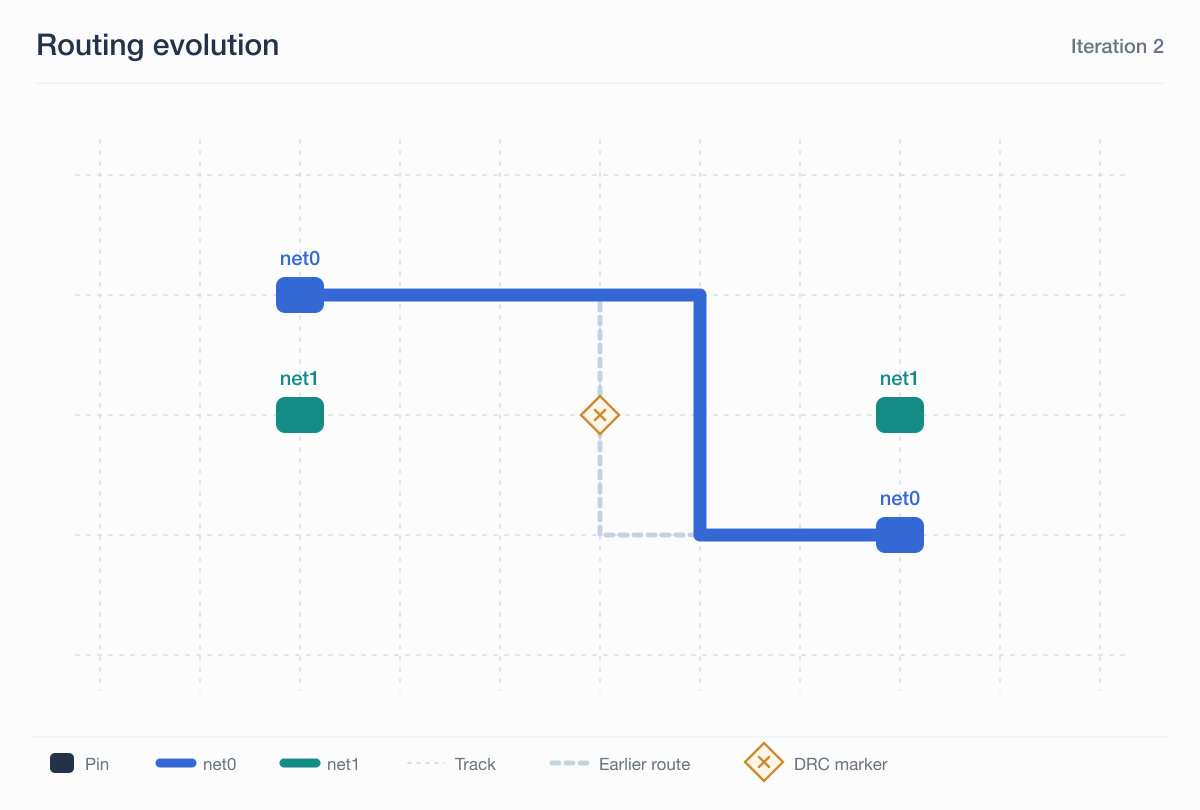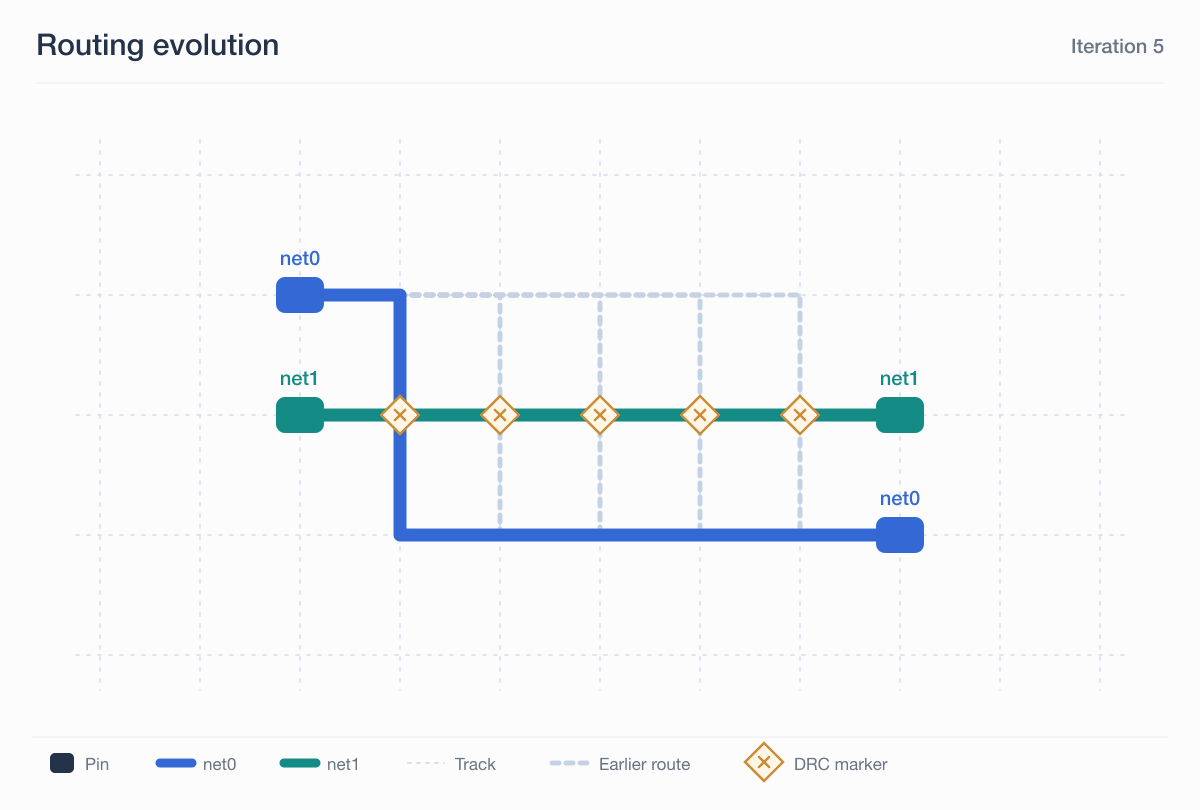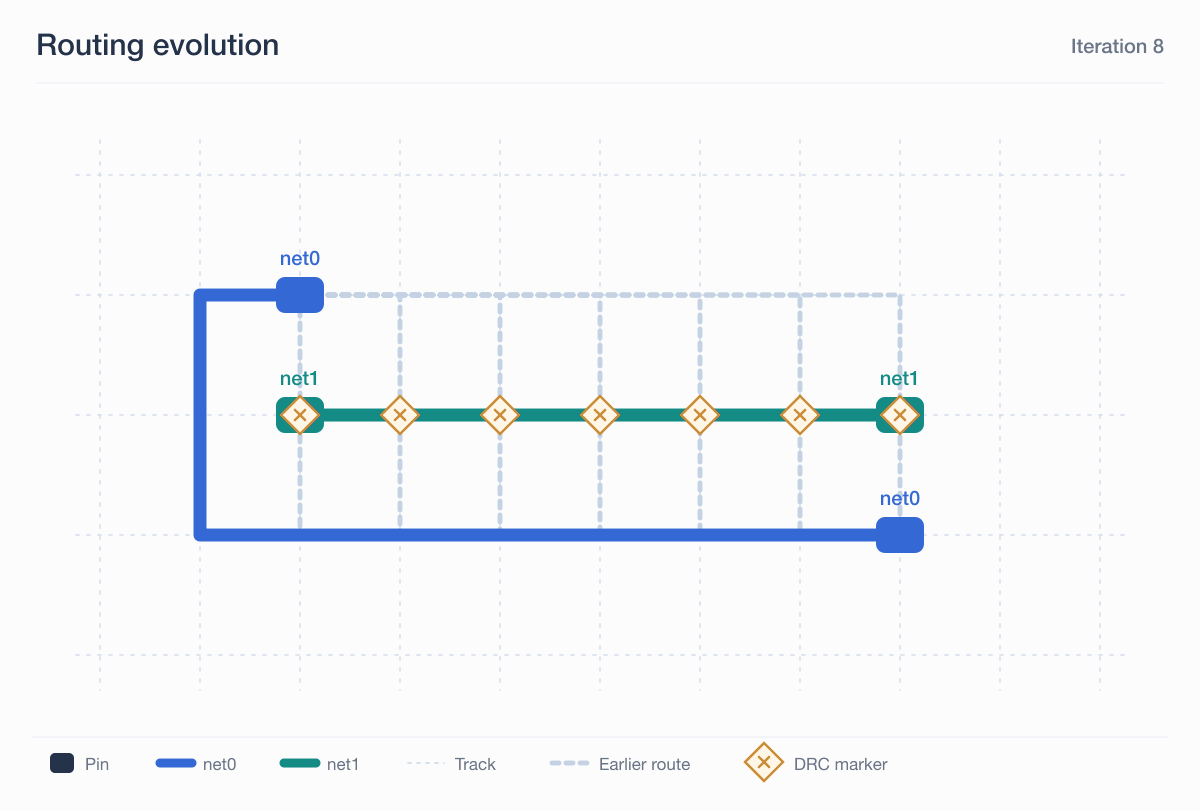
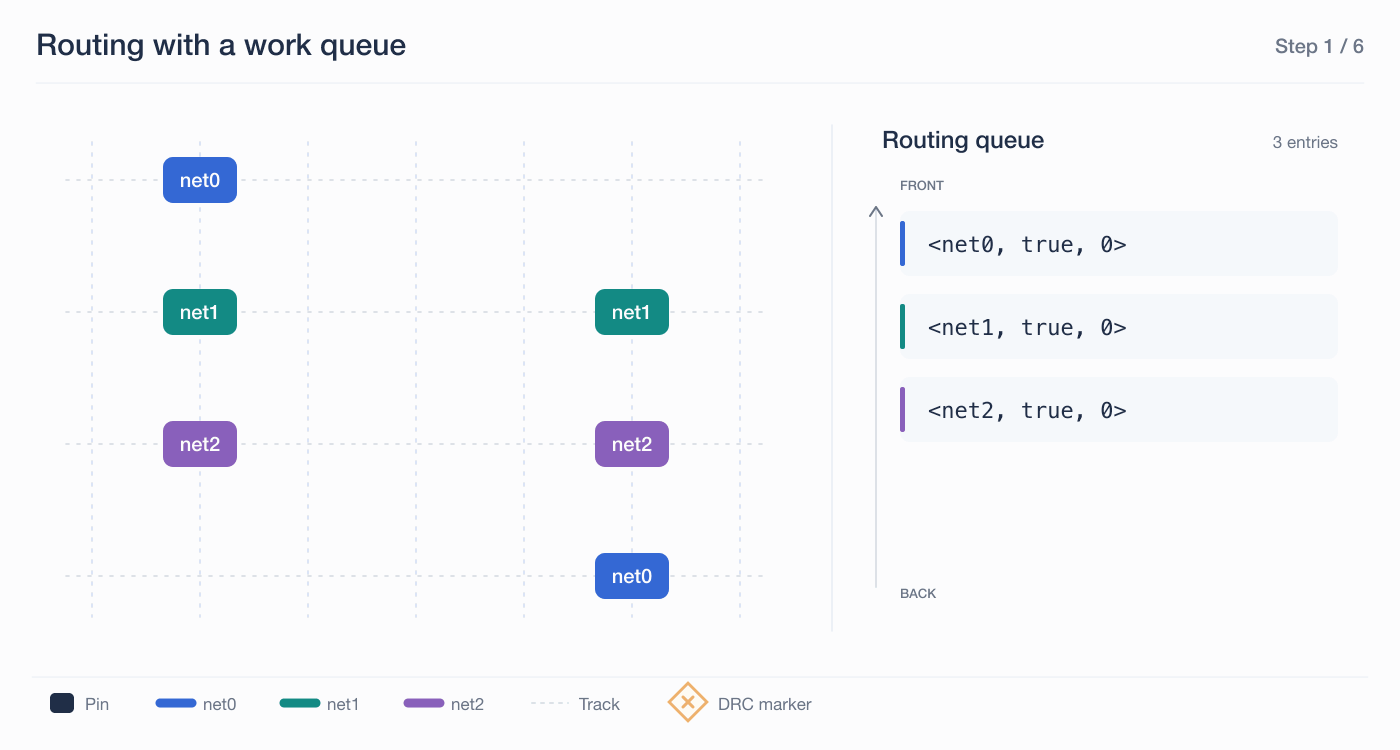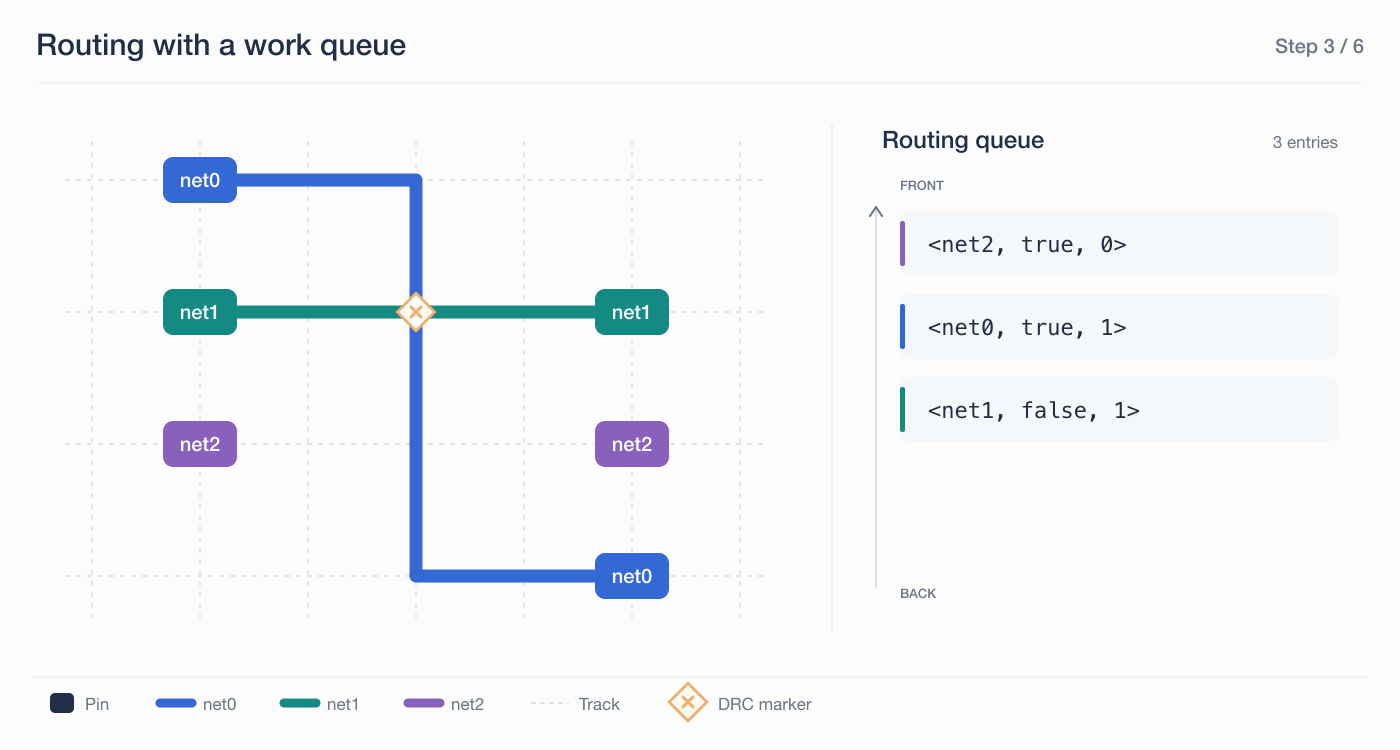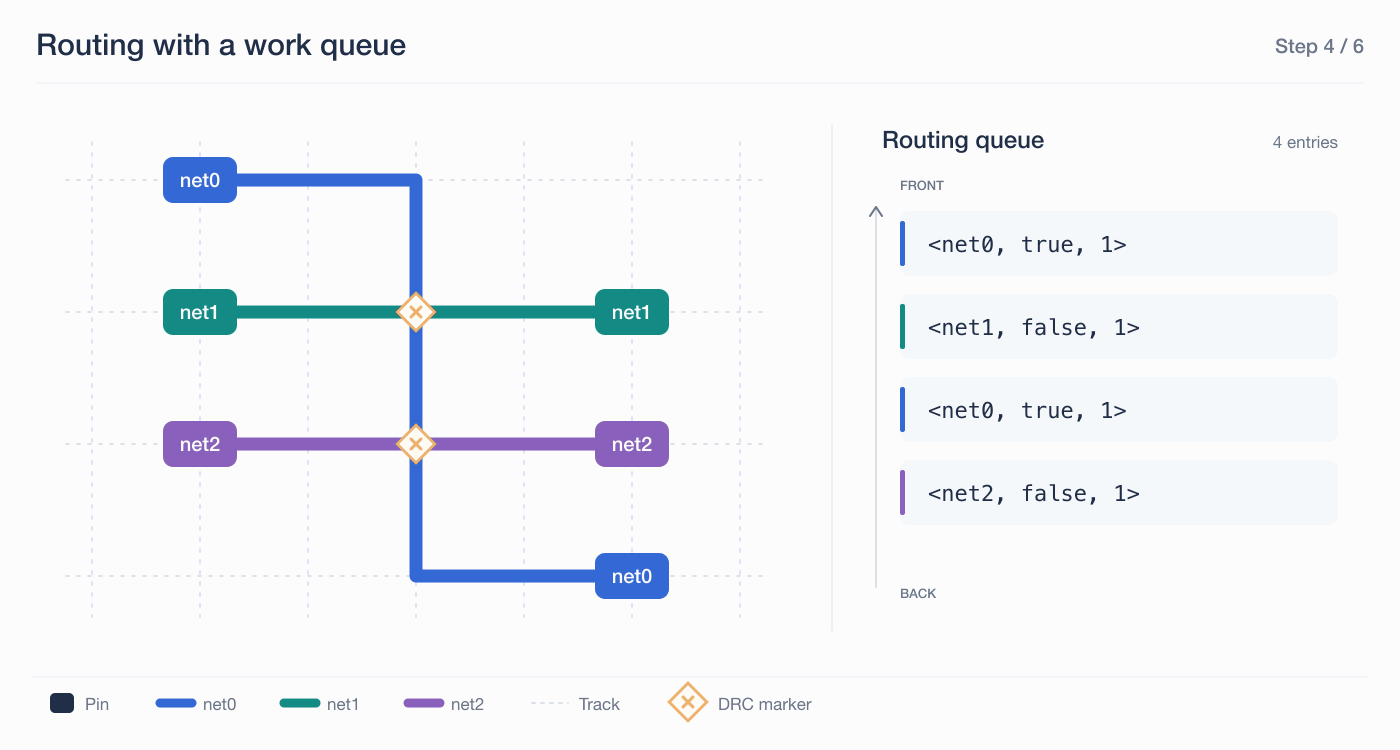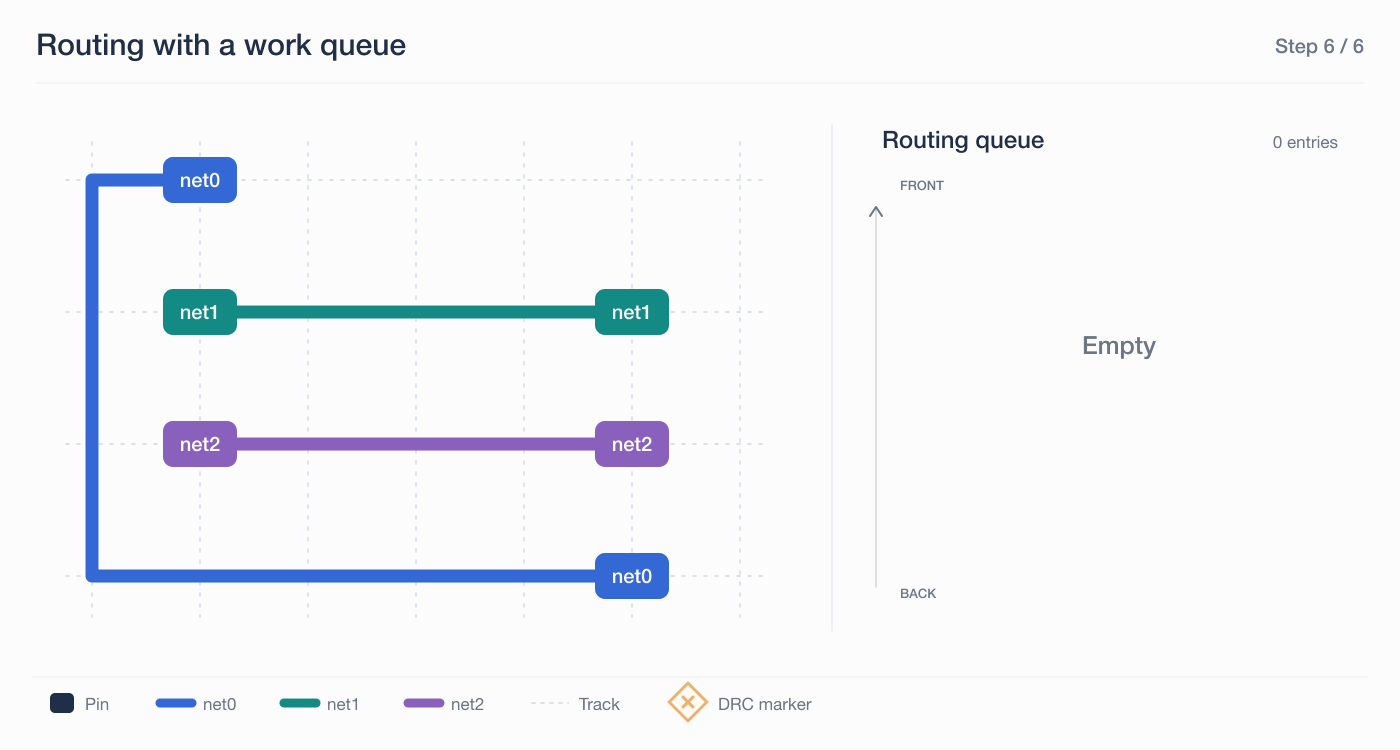
当多个线网竞争同一片布线资源时,先完成的走线可能限制后续线网的路径选择。因此,出现设计违例后,需要根据冲突关系重新安排部分线网的走线。Rip-up and Re-route的关键在于决定哪些走线需要调整,以及按什么顺序调整。 拆除范围过大会增加计算和扰动;始终要求后布的线网绕行,又可能保留不合理的早期路径。这一流程通常按以下过程迭代:
-
识别冲突:GR检测超容量的边,DR通过设计规则检查定位具体违例。
-
选择重布对象:选择经过拥塞区域或参与违例的线网、分支或局部走线。
-
Rip-up:移除选中的走线,释放对应资源并更新占用信息。
-
Re-route:根据更新后的路径代价重新搜索,并检查新方案是否仍存在冲突。
二、3DIC 布局算法
2.1 3D Global Placement
ICCAD 2022/2023 contest 统一了 3D Global Placement 的问题定义:
两个die采用Face-to-Face(F2F)方式堆叠,通过Hybrid Bonding Terminal(HBT)完成跨die连接;两个die可以采用相同或不同的工艺。线长评价将两侧的连接分别计算再求和:
\[W_e= \operatorname{HPWL}\!\left(P_e^{\mathrm{top}}\cup\{h_e\}\right) + \operatorname{HPWL}\!\left(P_e^{\mathrm{bottom}}\cup\{h_e\}\right)\]\(P_e^{\mathrm{top}}\)和\(P_e^{\mathrm{bottom}}\)分别表示net在两个die上的pin集合,\(h_e\)表示HBT的平面位置;未跨die的net则按所在die上的普通HPWL计算(后文统称D2D HPWL);该问题定义下的每个跨层net仅允许插入一个HBT连接。
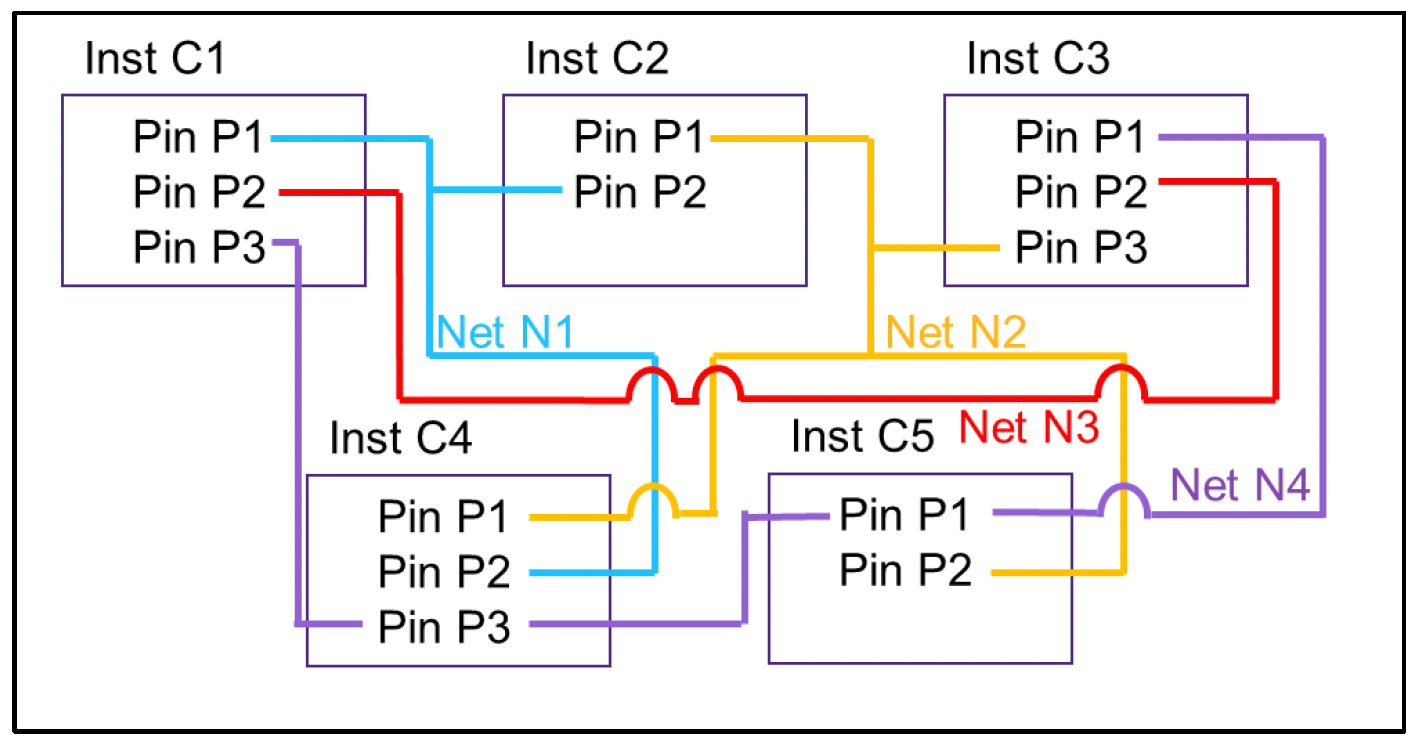
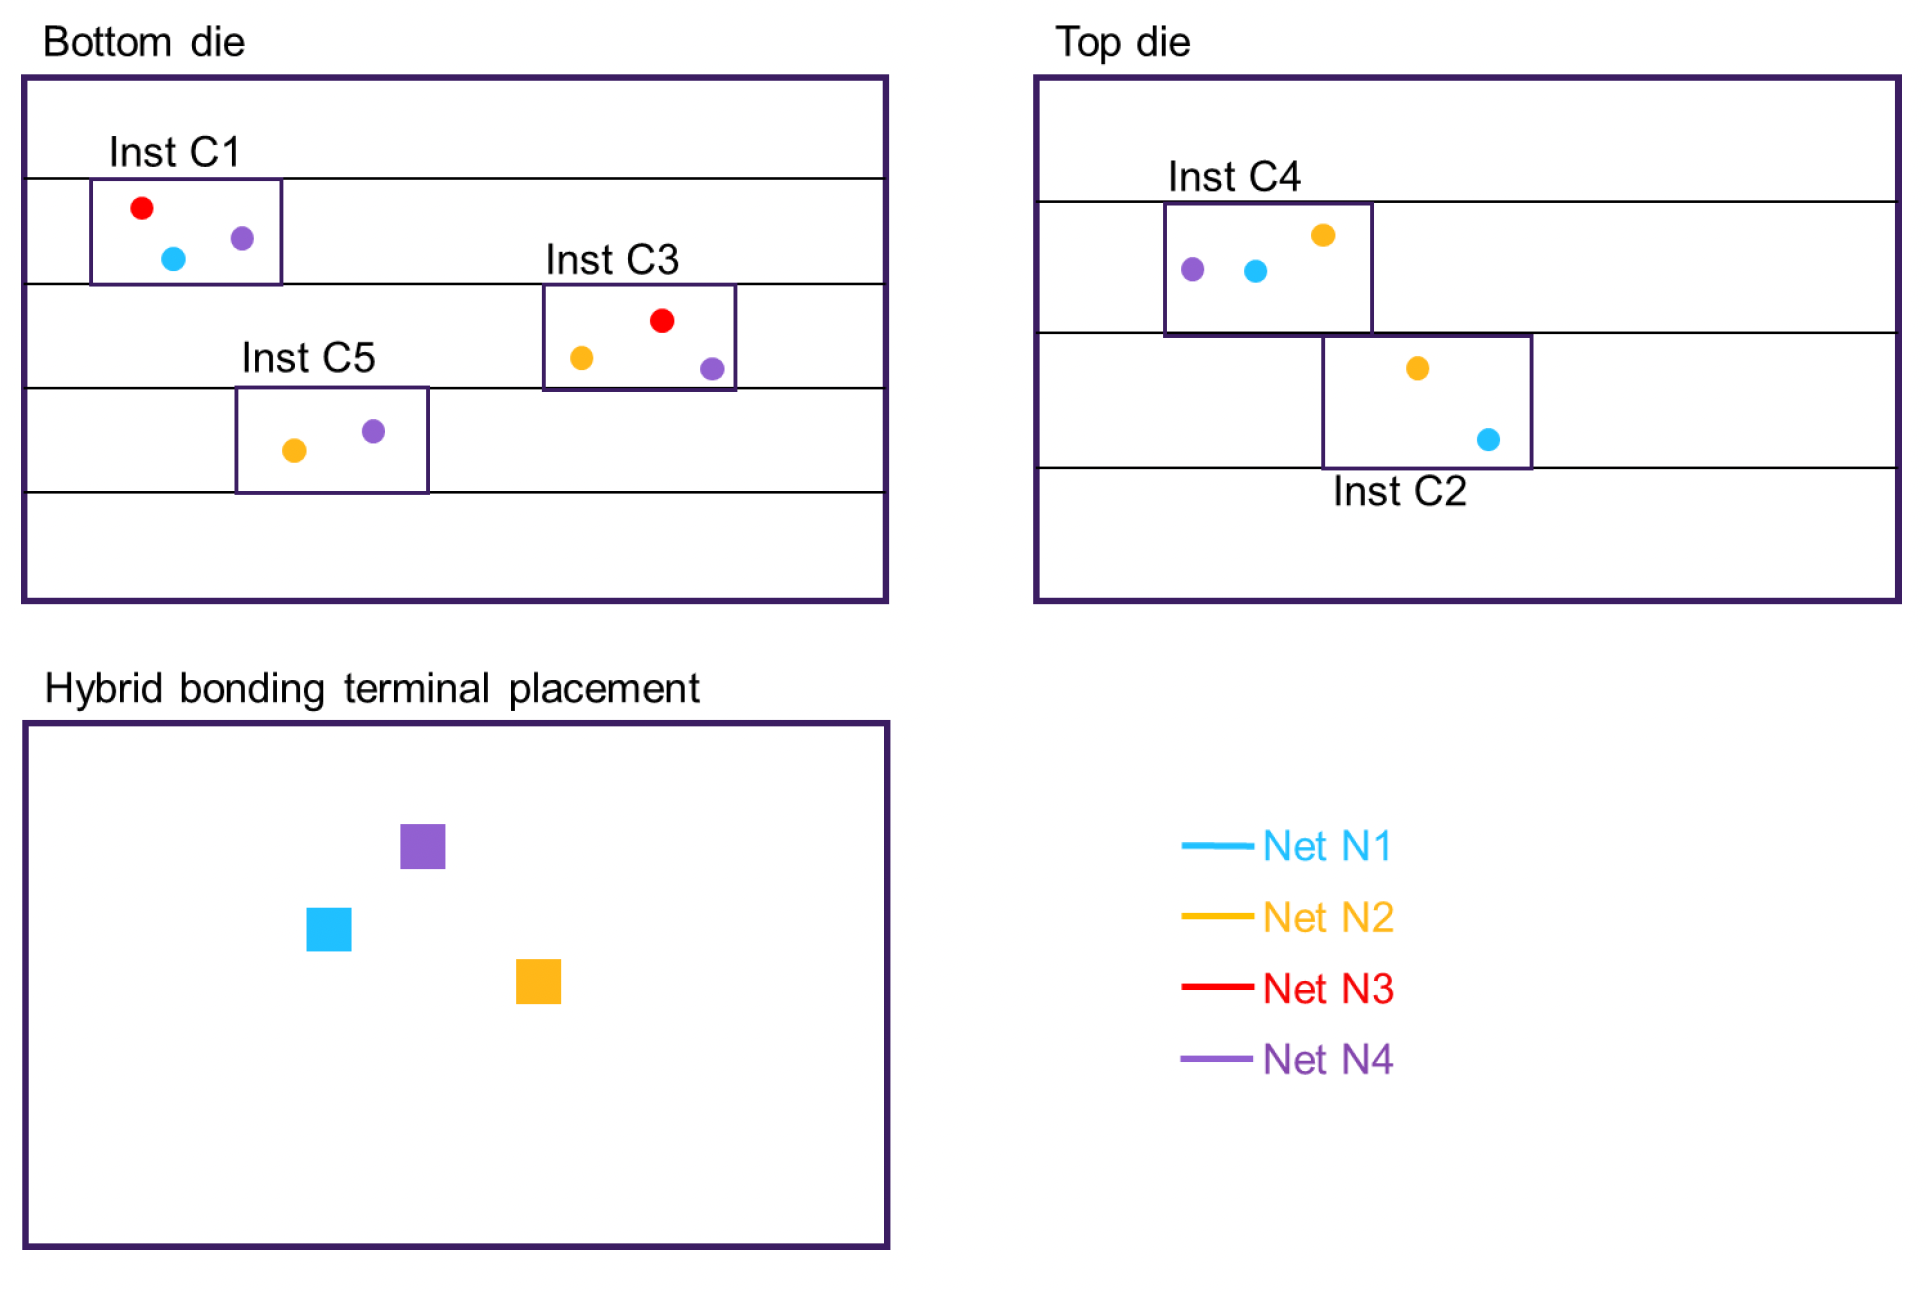
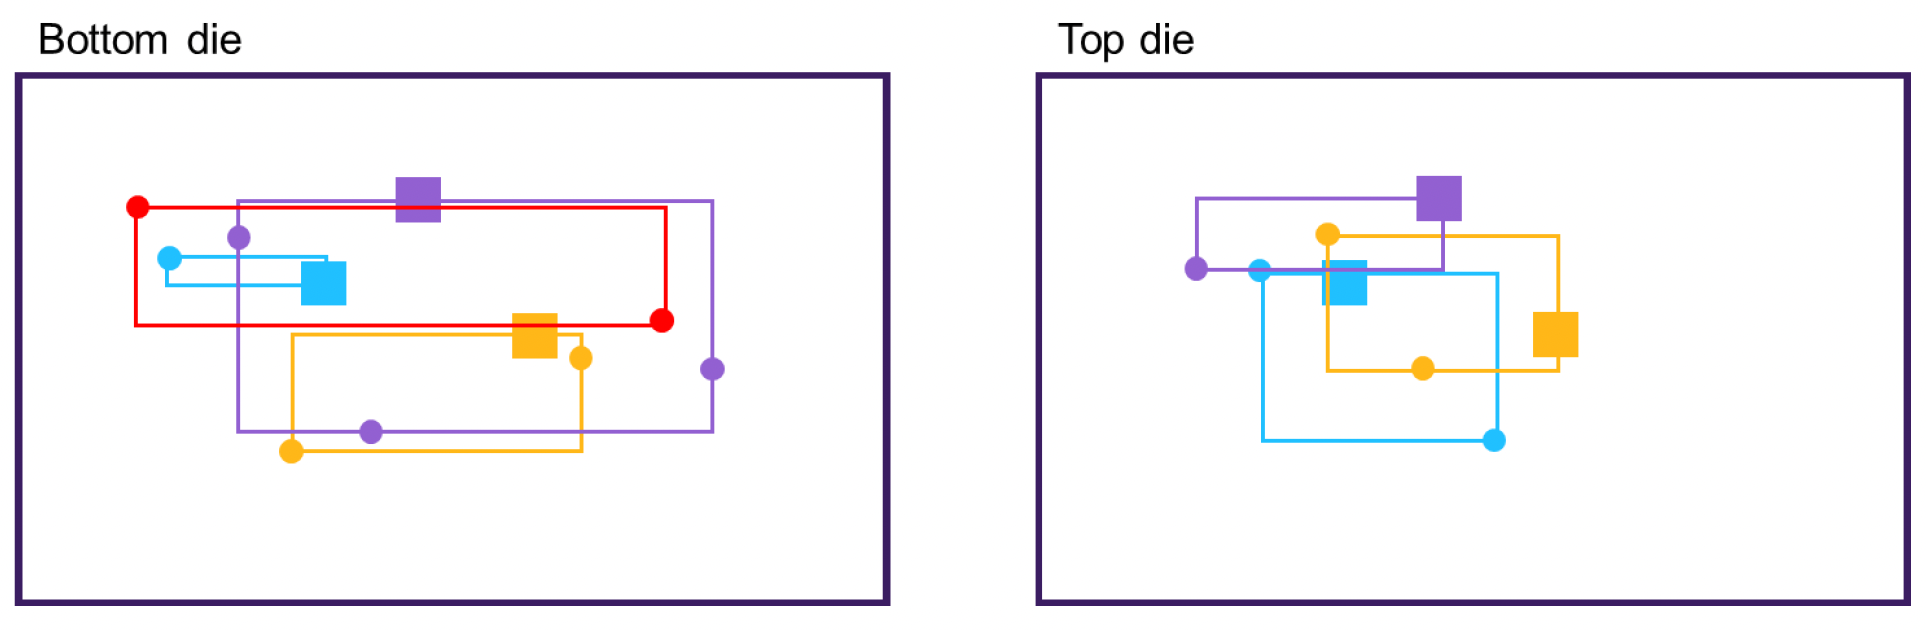
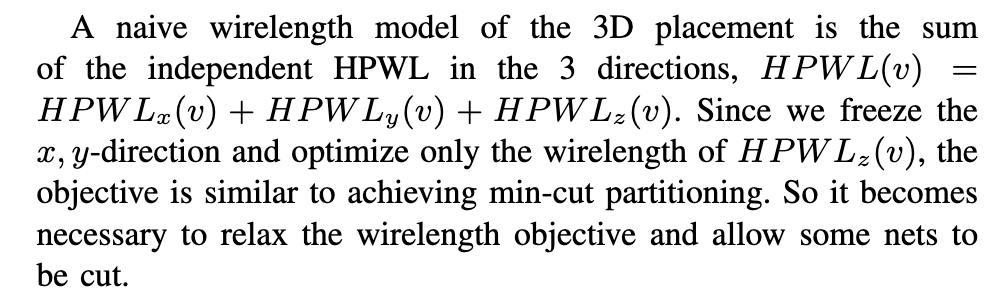
相较于二维解析全局布局,3D新增的关键难点是离散的层分配决策(z变量的优化)。同时,3D布局的线长评价指标受cell的平面位置,分层决策,HBT位置共同影响。仅按面积平衡划分cell,或者只最小化cutsize,都未必能得到较好的布局结果;而只优化平面位置,也无法判断哪些连接值得通过跨层重新组织。
3D布局如何处理z轴的离散决策,学术界主要被分类成两种解决方法:真3D(True-3D)和伪3D(Pseudo-3D):
2.1.1 Pseudo-3D GP (3D Partition)
- Bilevel Programming (2023-ICCAD)
早期的Bilevel Programming方法直接将 Partition 和 Tier Optimization 当成两个存在耦合关系的子问题。
将分区与布局建模为具有上下层依赖关系的双层规划问题,并采用交替优化框架求解:
-
给定分区结果,优化各die上的布局,评估当前分区对应的线长等代价;
-
根据布局提供的空间信息调整die assignment,再进入下一轮布局优化。
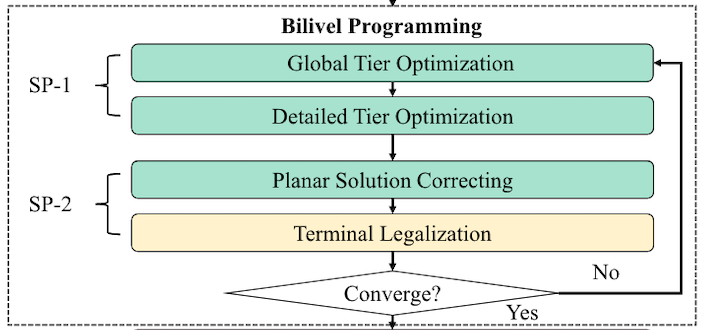
其主要思路是让两个子问题持续交换信息:分区决定布局的可行空间,布局则为下一轮分区提供更直接的代价反馈。相比仅以cutsize指导分区,这种方式能够更直接地考虑线长与跨层连接数量之间的权衡。
- Compact-2D/Shrunk-2D/Snap-3D/Pin-3D
Sung Kyu Lim教授的一系列工作,关注如何将3D设计转换为二维商用工具能够处理的表示,从而复用成熟的2D布局、时序优化、CTS和布线能力。它们主要需要解决两个问题:如何在二维工具中表达两个die的布局空间,以及如何让优化器看到的几何、寄生和连接关系能够反映实际3D设计的代价。
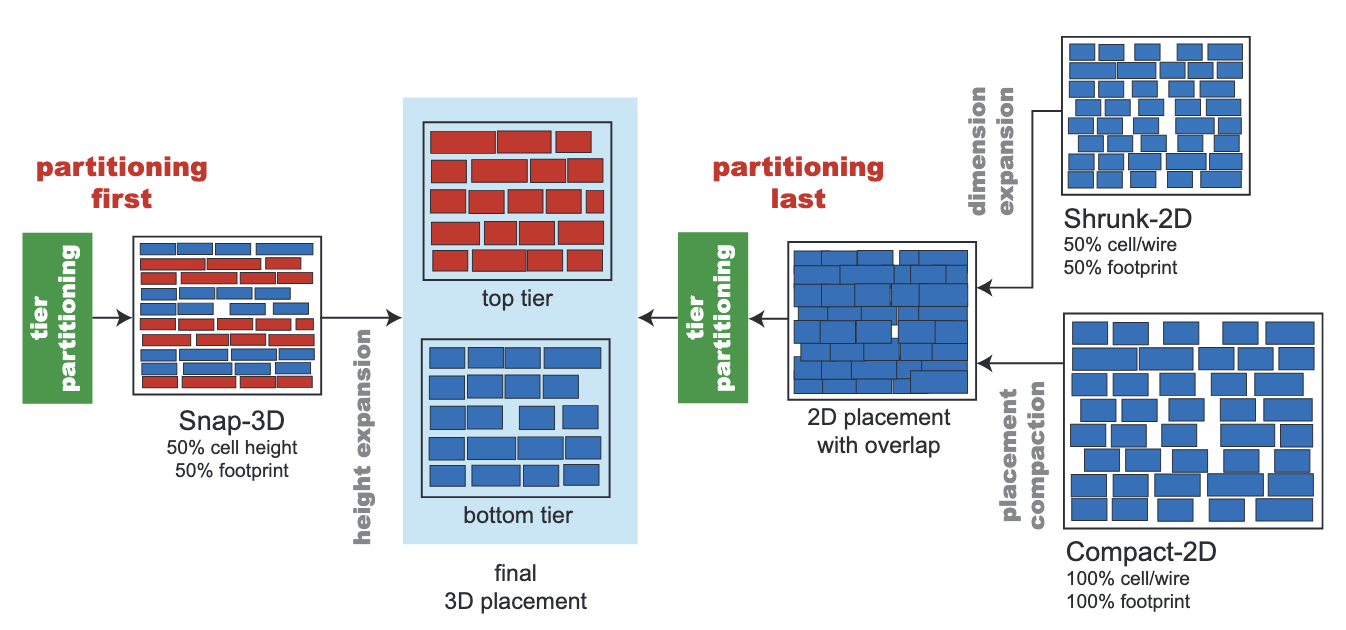
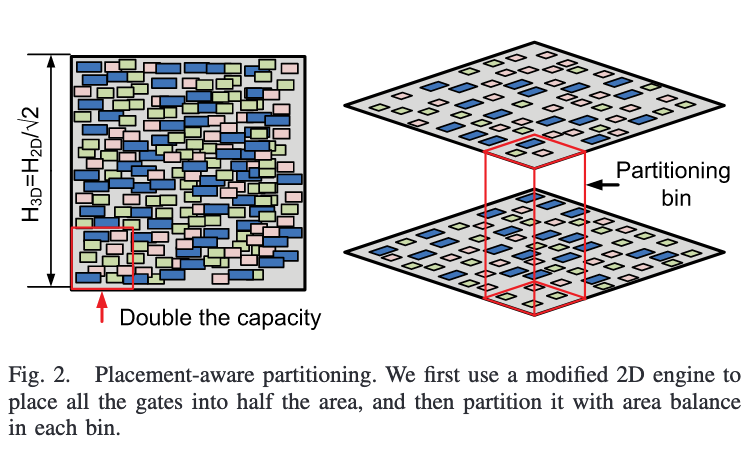
Shrunk-2D和Compact-2D都采用placement-aware的bin-based partition:根据已有二维位置划分partition bins,在各bin内施加上下die的面积平衡约束,并通过FM式换层操作减少cutsize。其目的不仅是平衡两个die的总面积,还包括限制分层后的局部聚集,减少后续合法化带来的cell位移。但这类流程是在主要二维优化之后才确定分层,分区和合法化仍可能改变原有连接代价。Compact-2D通过半高cell和row splitting,补充分层后的联合优化;Snap-3D则将分区提前到主要协同优化之前,再通过tier专属rows表达die约束,使二维工具能够在已知分层和完整3D metal stack的条件下,共同调整两侧cell的位置。
Pin-3D采用transparent die和pin projection,在保留原尺寸cell的情况下进行逐die优化。 优化一个die时,将另一侧cell固定并设置为COVER,使其不占用当前die的布局面积,同时保留其pin、连接关系和时序信息;两侧pin被映射到完整3D metal stack中的对应层。随后交换active die与transparent die,继续优化另一侧。这样,每次虽然只调整一个die,工具仍能看到完整的跨die路径,并据此执行布局、时序和时钟优化。Pin-3D可以承接Shrunk-2D或Compact-2D提供的初始布局与分区结果,继续完成3D实现。
| Shrunk-2D | Compact-2D | Snap-3D | Pin-3D | |
|---|---|---|---|---|
| 核心思路 | 缩小几何,在目标3D footprint内完成二维优化 | 保留几何,用RC缩放预估布局压缩收益,再进行分层后优化 | 提前确定分层,通过tier专属row约束共同优化两侧cell | 通过transparent die表示,在完整3D连接与时序信息下逐die优化 |
| 2D DB处理方式 | Cell长宽各缩小至\(1/\sqrt{2}\),metal width、pitch同步缩放 | 初始保留cell与metal尺寸,降低单位长度RC;后续压缩坐标,分层后使用半高cell和拆分rows | cell高度减半、宽度不变,调整pin几何,使用tier专属rows和3D metal stack | 保留cell尺寸;非active die使用COVER,pin映射到3D metal stack |
| partition时机 | 2D布局之后 | 2D布局、坐标压缩之后 | 初始2D布局之后,协同优化之前 | 使用已有分区结果 |
| 分层后的布局处理 | 恢复cell尺寸,进行各die的合法化 | 在压缩后的footprint中合法化,并进行分区后优化 | 将cell限制在所属die的rows内,共同优化两侧,最后恢复高度并拆回两个die | 固定transparent die,优化active die,再交换两侧角色;两侧连接与时序始终可见 |
| 可能的风险 | 几何缩放与分层转换可能使前序优化偏离实际3D代价 | 初始RC代理不包含完整跨die代价;半高cell方案可能带来潜在的pin access与DRC问题 | 平面优化受初始分区约束,不能通过跨类型row移动重新换层 | 每次只调整一个die,优化仍受初始分区与布局质量影响 |
这系列方法的区别在于如何利用二维优化所看到的几何、寄生和连接关系,并将其用于指导3D实现。
- CoPlace (2024-ASPDAC)
CoPlace 同样关注分区与布局之间的耦合,作者利用已有二维布局指导分区,并在分区过程中保留其空间关系。其主要流程包含三个阶段:
-
Compact 2D Placement: 先生成紧凑的二维初始布局,为分区提供cell之间的连接关系和局部密度信息。
-
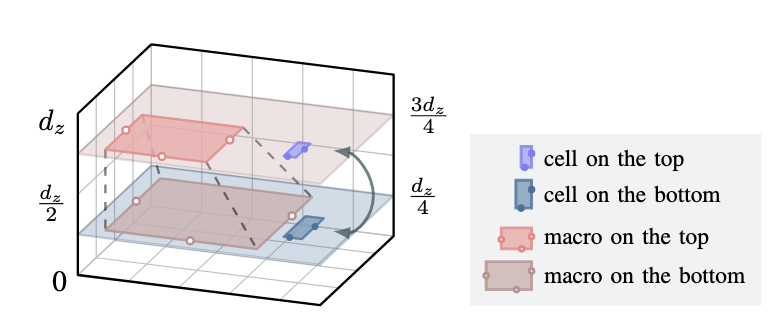
Layout-aware 3D Placement/Partition: 将布局空间扩展到三维,固定 cell 的 \(x,y\),仅沿 \(z\) 方向优化,再将连续的 \(z\) 坐标离散化,得到die assignment。
-
Multi-layer Co-Placement: 在确定分层后,联合优化上下两层cell和中间bonding terminal的平面位置,进一步缩短跨层线长。
值得注意的是CoPlace使用的3D Placement算法在优化过程中固定了x和y,仅对z进行优化,其目的是保留初始布局的空间关系;3D Placement得到cell的层分配结果后, Co-Placement 流程仍会调整平面位置。(这里的Co-Placement 也常被称为 2.5D Placement,指代多层协同布局算法)
CoPlace还强调,分区的balance不仅体现在各die的总面积或利用率上,也体现在各die内部的局部密度上。即使总面积满足约束,分区后仍可能出现局部聚集,迫使后续布局大幅移动cell。因此,它利用二维布局中的空间信息引导分层,使分区结果同时兼顾局部密度和已有布局质量。
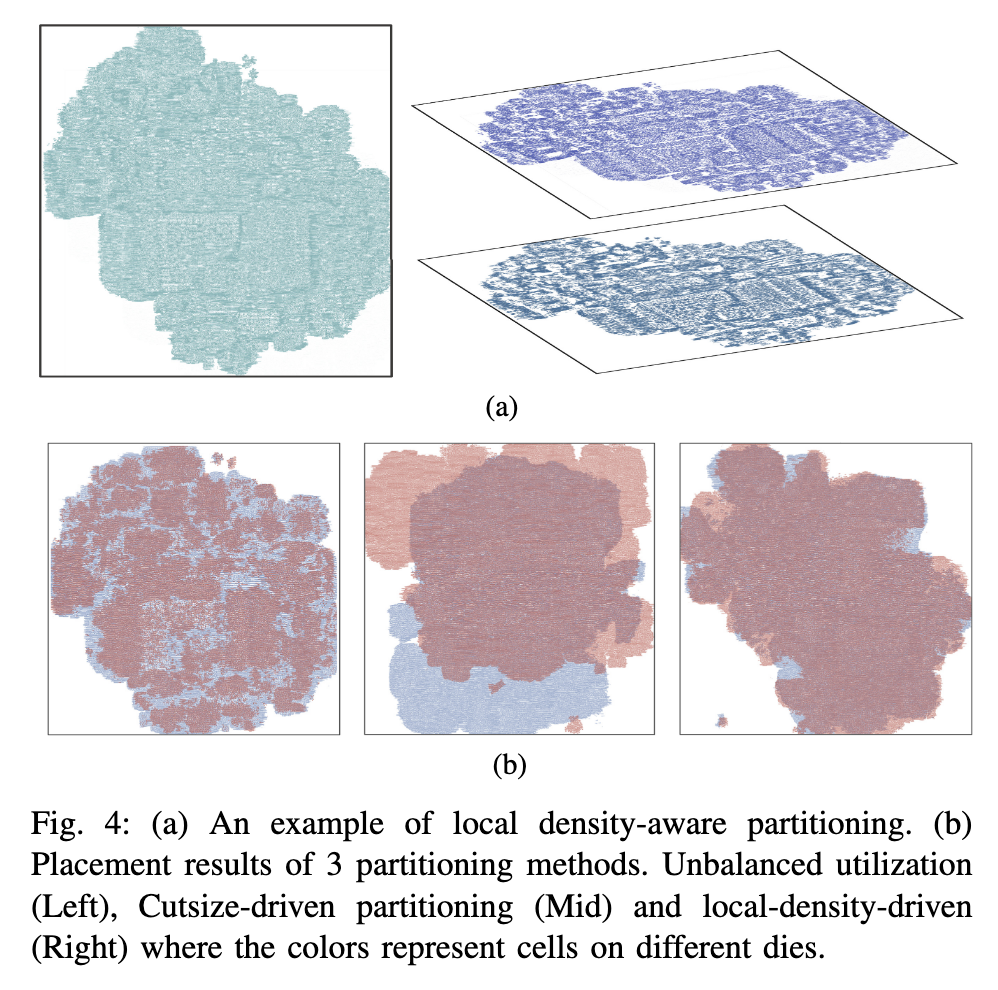
2.1.2 True-3D GP
- 3D 密度模型
- ePlace-3D
ePlace-3D直接将二维静电场模型扩展到三维:将cell建模为带正电的长方体,将布局区域划分为三维bin,依据cell在各bin中占据的体积计算密度,再通过三维Poisson方程求解电势和电场
与2D相比,电场力新增了z方向的分量:cell既可以通过平面移动缓解拥挤,也可以通过层间移动寻找可用空间。 三个方向的密度力与线长梯度共同作用,使布局在连续三维空间中逐渐展开。
但是,连续三维空间中的密度均匀,并不保证离散分层后每个die上的二维密度都满足约束。 连续优化时,一个cell的建模体积可以跨越分层边界;确定die assignment后,整个cell必须归属于某一层,其密度贡献随之重新分配。因此,三维密度优化之后仍需处理分层和层内密度。
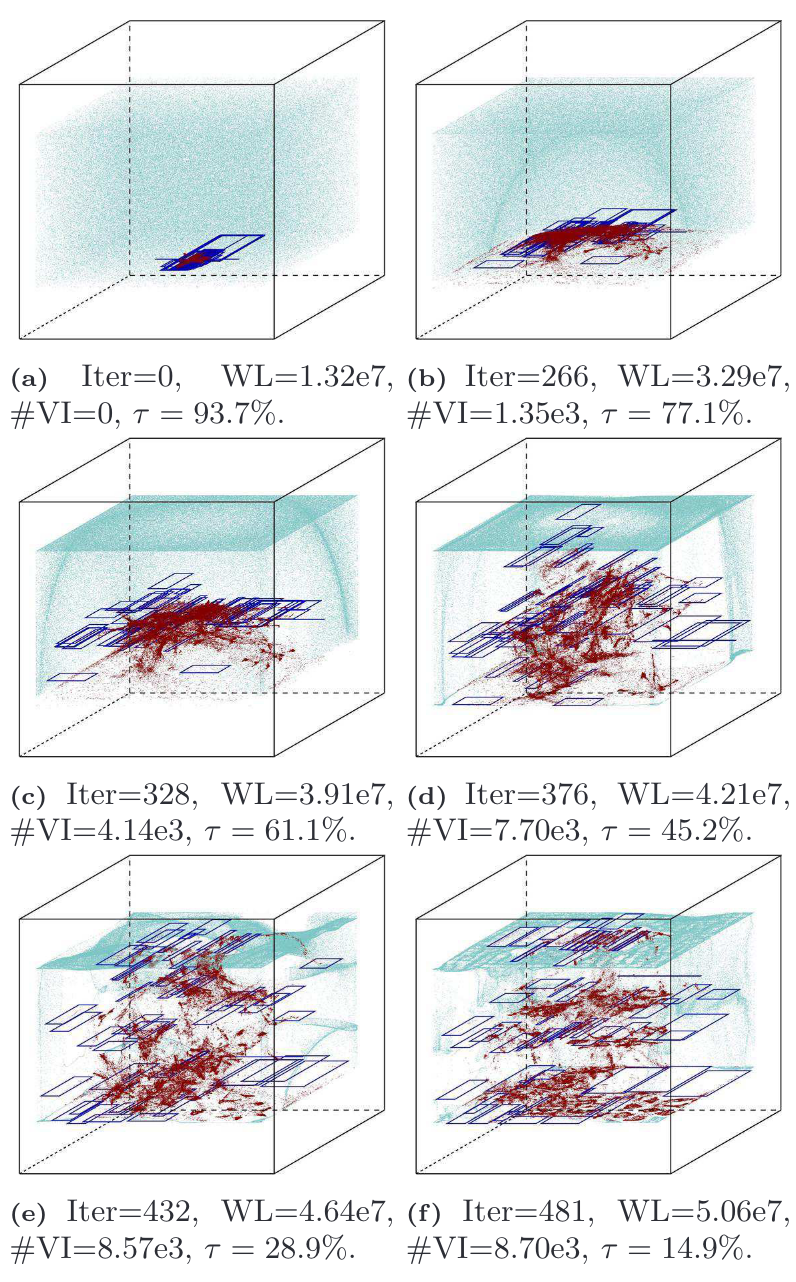
与密度模型类似,ePlace-3D时代的线长建模也采用了直接增加一个维度的设计思路。传统3D HPWL将一个net在三个坐标方向上的跨度加权求和:
\[\operatorname{HPWL}^{\mathrm{3D}}_e = \underbrace{\left(\max_{i\in e}x_i-\min_{i\in e}x_i\right) +\left(\max_{i\in e}y_i-\min_{i\in e}y_i\right)}_{\text{所有pin的平面投影HPWL}} + \alpha\underbrace{\left(\max_{i\in e}z_i-\min_{i\in e}z_i\right)}_{\text{垂直方向跨度}}\]其中,\(\alpha\)控制垂直互连相对于平面线长的代价。实际优化时,ePlace-3D使用WA模型对三个方向的max/min进行光滑近似,从而获得 \(x,y,z\) 方向的梯度。
这种3D线长模型的作用可以从两个方向理解:
-
平面线长项希望缩小整个net的Bbox边界,将相连的cell拉近;
-
垂直跨度项希望减小net跨越的层间范围,行为上期望同net放置于同die,增加z权重意味抑制跨层连接。
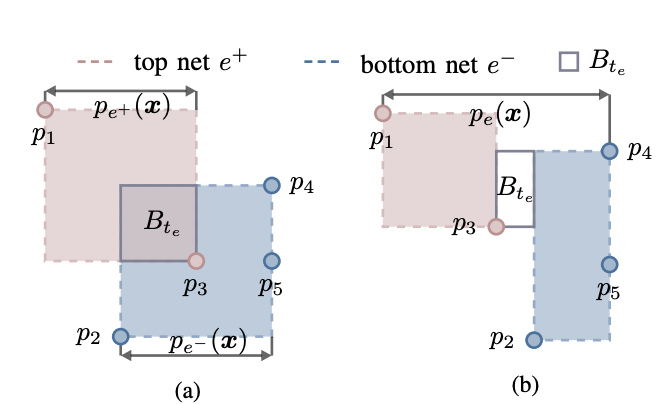
但这一优化行为与上文定义的D2D HPWL存在差异:3D HPWL计算的是整个net的平面投影跨度,D2D HPWL计算的是两个die各自连接到HBT的平面跨度之和。
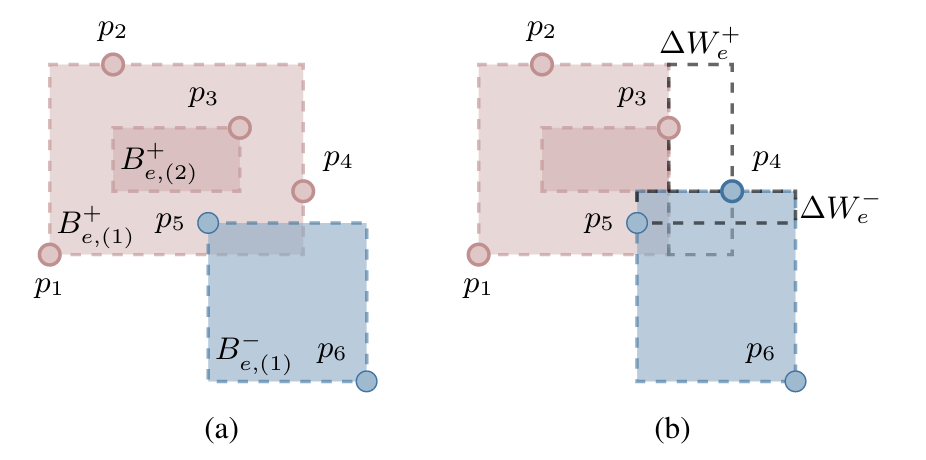
在给定cell位置和分层结果的理想假设下(忽略HBT合法性约束),可以根据上下die子网bbox的几何关系确定HBT的最优放置区域:取上下bbox的重叠区间或两者之间的间隔区间,构成HBT的最优放置区域;将HBT放在该区域内任意一点,都能获得相同的最小D2D HPWL。
当cell的位置固定时:
net仍然跨越两个die时,改变cell的分层组合不会改变传统3D HPWL,却可能改变D2D HPWL;
net的任何分层结果得到的D2D HPWL都不可能小于相同位置映射后的2D HPWL。
- 3D 线长模型
- Bistratal Wirelength Model
Bistratal WM采用有限差分近似(Finite Difference Approximation,FDA)构造梯度:在固定cell平面参考位置的条件下,比较其分别归属两个die时的线长,以换层前后的线长差构造 \(z\) 方向的代理梯度,从而指导分层优化。但其线长评价仍依赖离散分区:当pin跨越分层边界时,所属子网随之切换,目标函数也可能发生跳变。
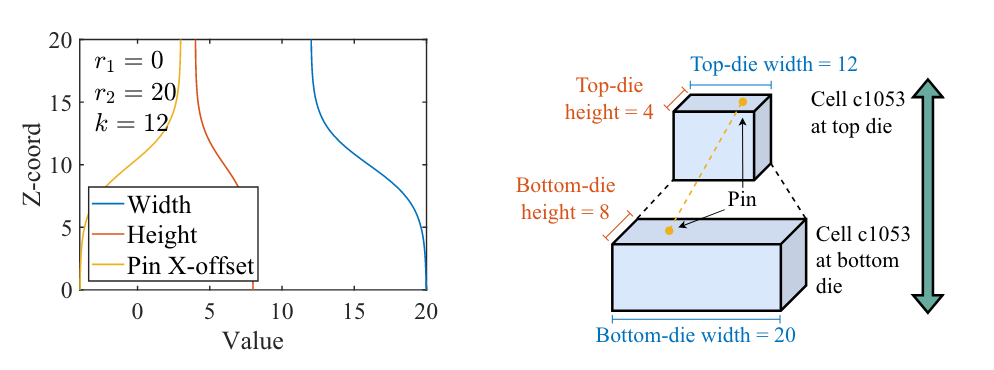
对于异构工艺,Bistratal布局框架会根据当前die assignment动态更新cell尺寸和pin offset。 每次迭代先由 \(z\) 确定暂定的离散分层,再选择对应工艺下的cell宽高和pin offset:尺寸变化影响密度计算,pin offset变化则影响线长计算中的pin坐标。因此,FDA在比较两种归层方案时,既考虑上下子网连接关系的变化,也考虑工艺切换引起的pin位置变化;即使cell参考点的 \(x,y\) 不变,其pin坐标仍可能改变。这一处理采用两套工艺参数之间的离散切换。当cell跨越分层边界时,所属子网、cell尺寸和pin offset可能同时变化,因此线长仍可能发生跳变。
Bistratal 后续工作保留了基于D2D HPWL的线长建模,通过Gumbel-Softmax生成连续的归层权重,对两种die assignment下的Bistratal线长进行加权 score,从而平滑硬分层切换带来的线长跳变。
- MTWA(Multi-Technologies Weighted-Average) Wirelength Model (异构专用)
MTWA仅关注异构3D的线长光滑建模:同一个cell的尺寸和pin offset在布局过程中可能随die assignment改变。如果在分层边界处直接切换两套工艺参数,pin坐标会发生跳变。MTWA利用sigmoid函数对不同工艺下的pin offset进行连续过渡,再将得到的pin坐标代入WA模型。cell在两层之间移动时,pin offset会平滑地从一种工艺过渡到另一种工艺,使工艺切换对平面线长的影响能够参与梯度计算。
这篇工作在Global Placement阶段仍以传统3D HPWL为基础,MTWA主要补充的是分层带来的几何变化,也并未完整表达分层后两个子网各自的连接代价。如果两套工艺的pin offset完全相同,MTWA通过offset变化传递的线长项梯度就会消失。
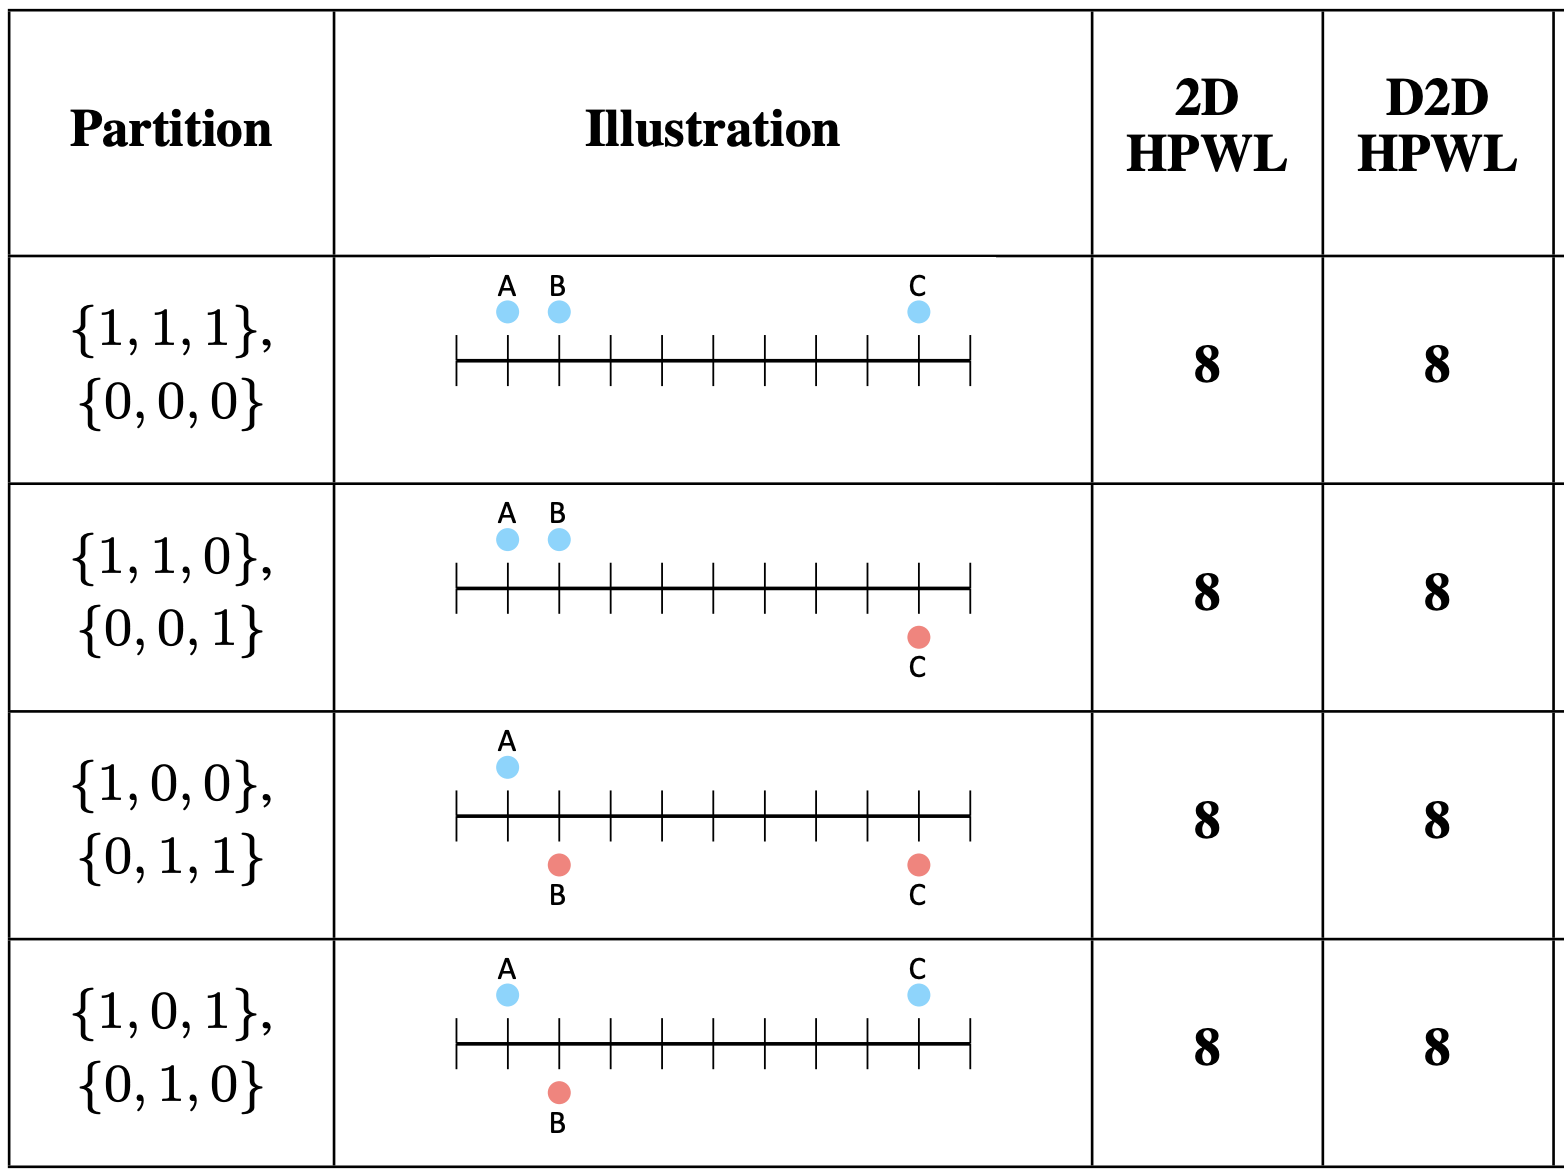
Dual-Max希望让 z 的优化充分考虑分层结果与平面位置之间的关系。 改变一个cell的die assignment,会同时改变上下die的pin集合,以及两个子网的bbox边界。因此,分层决策需要结合当前的 \(x,y\) 位置,判断将哪些pin放在同一die,能够使各die内部的连接更加紧凑。但在理想HBT位置假设下,不同分区可能得到相同的D2D HPWL。这使线长目标难以区分这些分层结果。我们因此在分区阶段暂时排除HBT连接,构造强调各die内部几何关系的线长代理,使分层带来的连接范围变化能够直接参与优化。
右图这个3-pin net中,A、B、C的平面坐标分别固定为1、2、9,A和C分别位于两个die上,只优化B的归层概率 \(z_B\)。
B与A相距1,与C相距7,因此两种分层结果对应不同的层内连接范围: B与A同层时,该层的连接跨度为1,另一层只有C,跨度为0;B与C同层时,两层的跨度之和则为7。但如果加入位于最优位置的HBT,两种分区的D2D HPWL都为8,线长评价无法区分这两种分层结果。
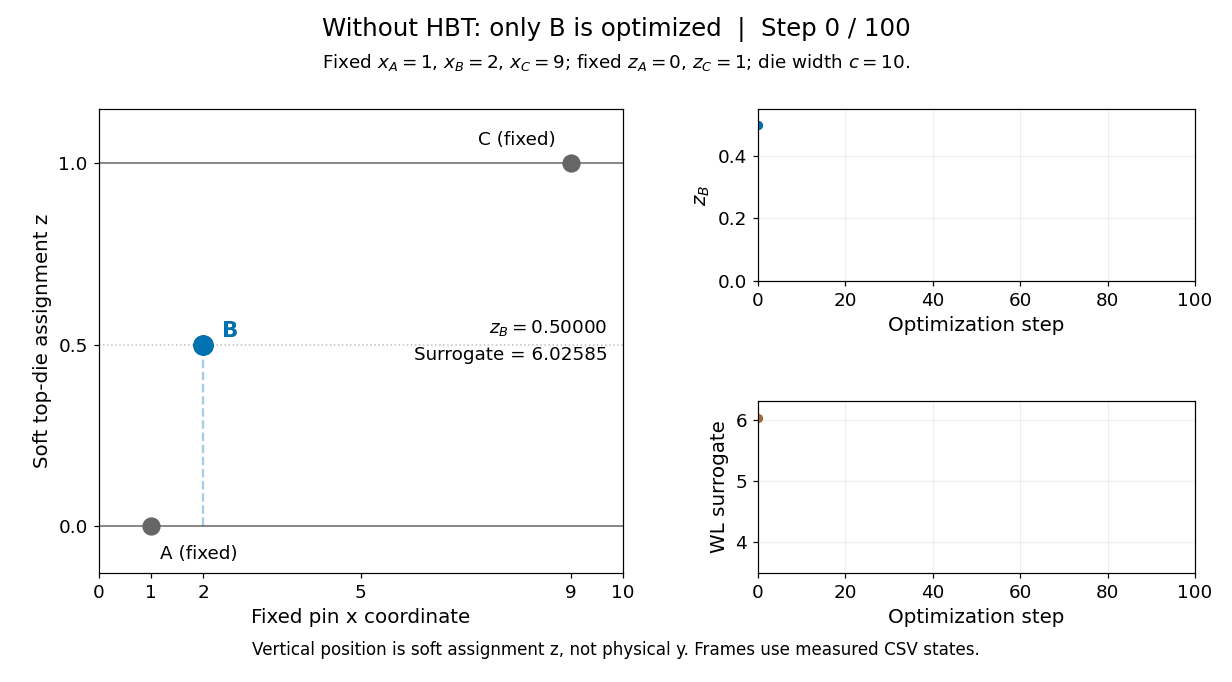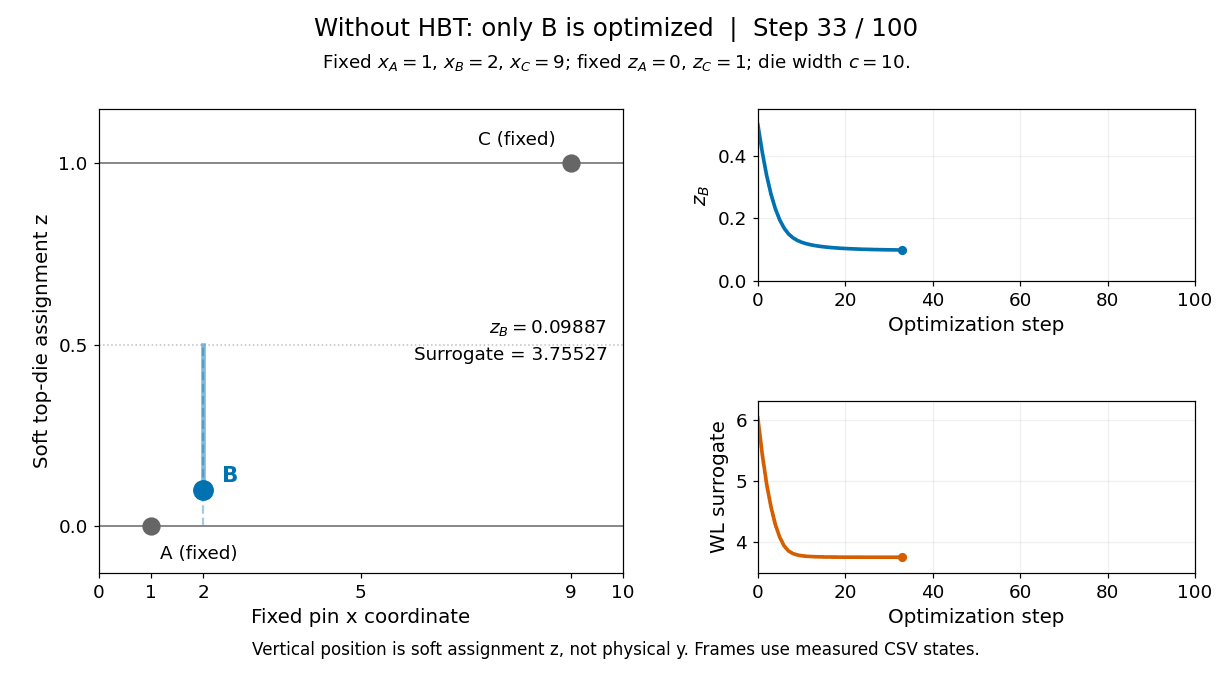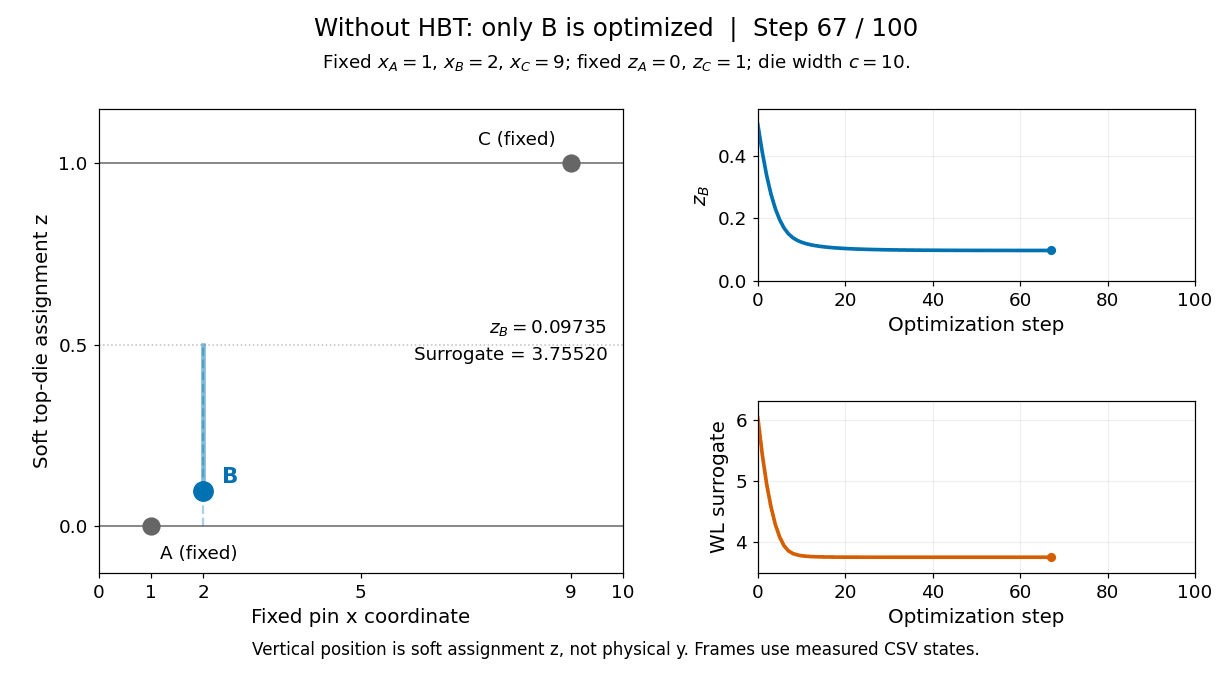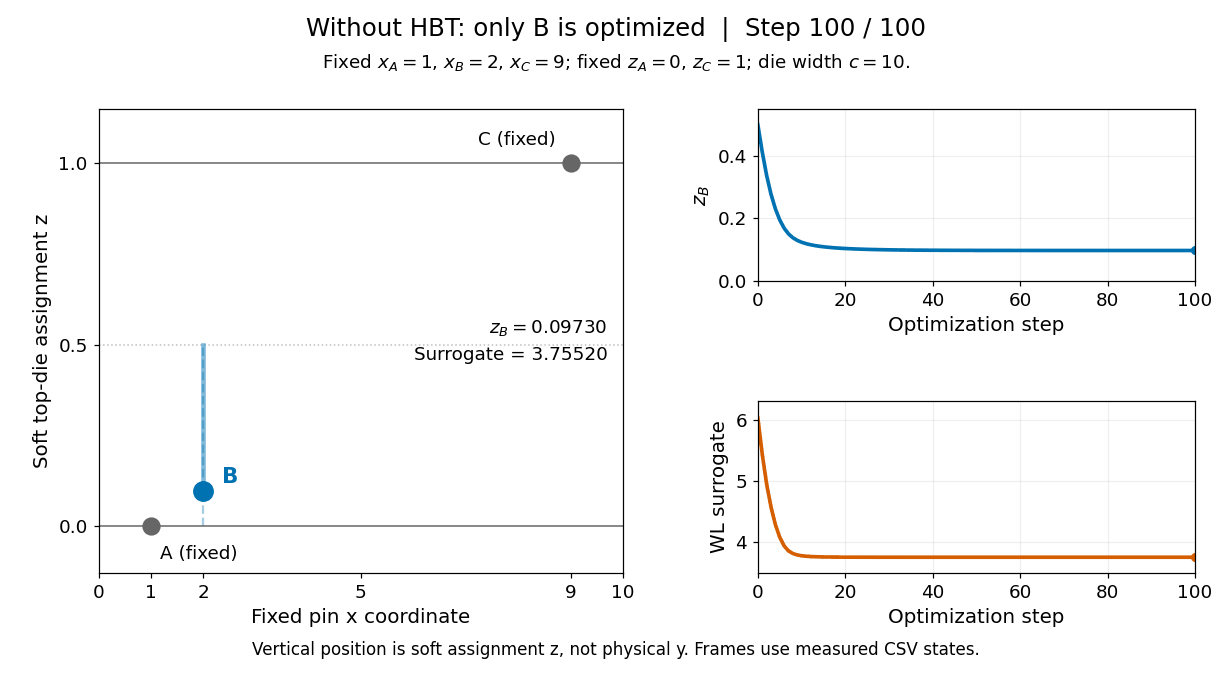
Dual-Max希望将这种空间关系转化为 \(z\) 方向的优化信号:排除HBT连接,让B对上下die线长代理的贡献随归层概率变化,引导 \(z_B\) 向0移动,使B倾向于与距离更近的A同层。Dual-Max将分区概率直接引入各die的几何极值计算,使pin的位置和归层概率共同决定其对线长代理的贡献。分层概率变化时,pin对上下die子网边界的影响也随之变化;而pin位置改变时,模型对分层方案的评价也会相应调整,从而为平面位置与die assignment提供耦合的优化信号。再通过LSE光滑和偏置处理构造代理梯度,使连续的分层优化能够利用各die内pin的几何分布。
实际实验下来Dual-Max模型在计算时考虑HBT的位置可以加速线长收敛,同样也可以获得预期分层结果。
极端假设:异构工艺的True-3D GP工具,如果像2D优化算法一样仅考虑Wirelength (3D HPWL) 和Density (ePlace-3D) 的带罚非线性优化。那么在布局早期几乎大部分cell都会被拉到工艺节点更小的Die上,需要依靠后期的强 Density 力强制将堆积的cell推往另一层或使用更直接的legalization算法解决Die间分布不均的问题。
2.1.3 Cutsize/Timing-driven/Local balance/HBT congestion……
线长和密度模型,为3D布局提供了可以求解的优化目标,但HPWL下降、density overflow达标,并不足以说明最终设计的时序已经改善。
LogicFolding 能获得收益需要满足一个基本条件:空间重组和线长缩短带来的收益,应当超过垂直互连新增的RC代价。 跨 die 时序收敛还需要考虑两侧工艺变化、阈值电压、驱动能力与互连RC差异,尤其会影响clock distribution和hold margin……
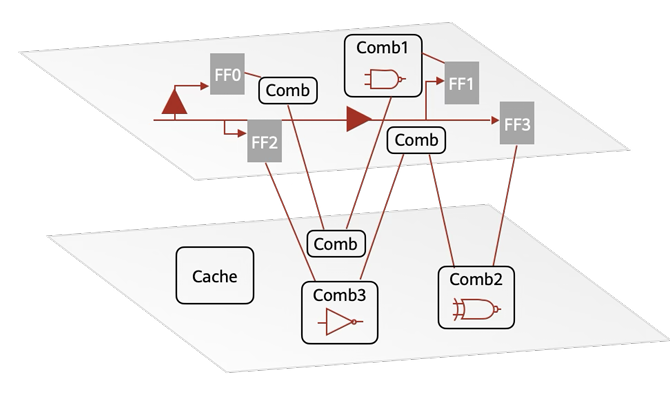
对布局算法而言,这意味着3D分层决策不能只考虑二维平面线长是否变短,还需要判断:缩短了哪些连接,新增的跨die代价落在哪些路径上,以及后续合法化和布线能否保留这些收益。因此,许多3D布局研究以各种方式引入了以下Cutsize、Timing-driven、Local balance、HBT congestion等优化因素。
这些因素之间也存在相互制约:为了减少关键路径上的跨层连接,可能需要把更多cell放到同一die;但局部密度上升又会增加合法化位移和绕线。优化目标需要同时反映这些变化,避免把当前阶段的收益转化为后续阶段的修补代价。
- Snake-3D (Differentiable Partitioning)
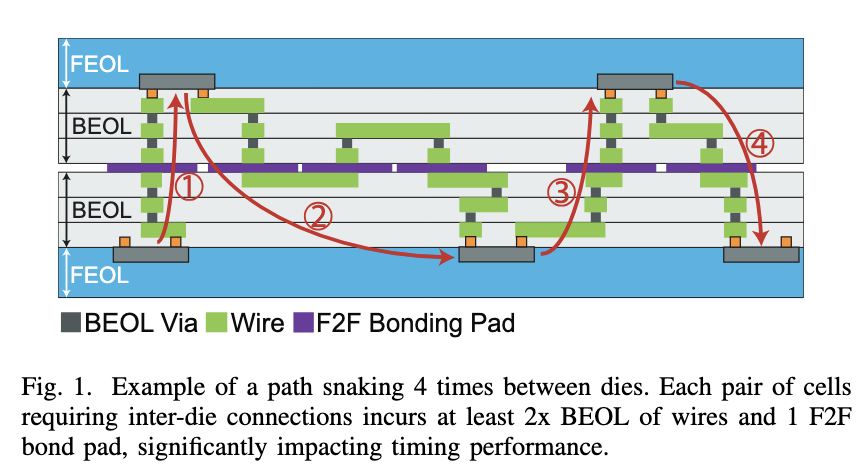
Snake-3D关注跨die连接沿逻辑路径的分布。当相邻逻辑cell交替位于上下die时,信号会沿同一条时序路径反复跨层,作者将这一现象称为 path snaking。在F2F结构中,每次跨die连接都需要经过两侧的BEOL和bonding interface,其代价包含沿途金属线、via和bonding terminal的RC。因此,即使总体cutsize下降,剩余的跨die连接仍可能集中在critical path上,抵消平面线长缩短带来的时序收益。
Snake-3D在分区阶段固定cell的xy优化,仅对z方向进行可微优化。 它利用前序pseudo-3D布局布线提供的时序路径信息,优先减少关键路径上的跨层次数,同时控制总体cutsize和各die的局部密度。作者将其定位为partitioner,用它替换Pin-3D flow中的bin-based partitioning;分层结果确定后,仍由后续流程完成3D placement、legalization和routing。
对True-3D GP而言,一个可行的改进方向是在联合优化位置与分层时,进一步考虑真实绕线路径级的跨层代价,使优化目标能够更好地预测最终时序。后续3D布线还需要决定具体的metal layer、HBT位置和走线路径;拥塞、pin access与设计规则都可能使实际连接偏离布局阶段的理想估计。
2.1.4 Multi-Die Co-Placement
分层结果确定后,cell与HBT的位置仍然相互影响。GP阶段对HBT位置的理想假设可以独立求解每个net的最优位置,但实际设计规则约束下多个HBT可能竞争同一片区域;为了满足间距要求而移动HBT,又可能增加两侧的线长。同时,分层后的cell也需要进一步调整位置,以降低各die内部的密度overflow。
几乎所有学术界的True-3D GP结束之后都需要引入Multi-Die Co-Placement:固定die assignment,联合优化各die内cell与HBT的平面位置。对于每个跨die net,算法将其拆成上下两个子网,并将同一个HBT作为两侧共享的连接点。HBT移动会同时改变两个子网的线长,cell移动也会改变HBT的最优放置区域。通过联合优化,这些变化能够在同一轮迭代中相互反馈。这类方法在论文描述中暂时没有统一的名称:
| 论文中的相关命名 | 对应文献 |
|---|---|
| HBT-Cell Co-Optimization | [1] Chen等,“Mixed-Size 3D Analytical Placement with Heterogeneous Technology Nodes.”,DAC 2024 |
| Multi-Die 2D Global Placement | [2] Zhao等,“Analytical Heterogeneous Die-to-Die 3-D Placement With Macros.”,TCAD 2025 |
| Multi-electrostatic 2.5D Global Placement | [3] Fu等,“CoPlace: Coherent Placement Engine with Layout-aware Partitioning for 3D ICs.”,ASP-DAC 2024 |
| 2.5D Global Placement | [4] Ji等,“Integrated Timing-driven Placement for Hybrid-Bonding-based Face-to-Face 3D ICs.”,DAC 2026 |
他们的共同思路都是将布局对象分为三个独立的密度层,三层需各自满足密度约束,并通过共享HBT的线长项耦合。
\[\min_{\mathbf{v}} \sum_{c \in \{0,1\}} \mathrm{HPWL}(v^c \cup v^b) + \langle \lambda, D \rangle\]2.2 3D Detailed_Placement/PlaceOpt
本节待补充:原始材料尚未展开 3D Detailed Placement / PlaceOpt 的内容。
三、3DIC 布线算法
3DIC布线核心仍然依赖Pattern Routing、Maze Routing和Rip-up and Re-route等基本算法。新增的关键问题是:一条net的哪些连接放在哪个die上完成,需要多少次跨die连接,以及这些跨die连接产生的HBT应当落在哪里。
这些决策不仅受布局得到的cell位置影响,还取决于堆叠形式、两侧的金属资源和跨die连接的工艺约束。
3.1 3D堆叠形式
从布线角度看,堆叠形式首先决定两个die的哪些金属层相邻,以及跨die连接需要经过哪些结构。
-
Face-to-Face(F2F): 两个die的正面金属相对,通常通过bonding interface连接两侧最外层金属。对于Hybrid Bonding,HBT的位置和接入方式共同决定两侧子网如何连接。
-
Face-to-Back(F2B): 一侧die的正面朝向另一侧的背面,跨die连接还需要经过背面或硅层,到达另一侧的互连结构。具体实现可能涉及TSV、背面互连或MIV,其占用资源、寄生参数和接入约束与F2F不同。
F2F和F2B的差异不仅是die的朝向,还会改变跨层路径需要经过的金属层,以及可以共享的布线资源。后文主要讨论的是基于F2F Hybrid Bonding的布线算法。
3.1.1 3D Metal Stack设计
对F2F堆叠,可以将两侧BEOL与bonding interface组织为一个统一的金属栈:
\[M_1^{\mathrm{bottom}} \rightarrow\cdots\rightarrow M_n^{\mathrm{bottom}} \;\xleftrightarrow{\mathrm{HBT}}\; M_m^{\mathrm{top}} \rightarrow\cdots\rightarrow M_1^{\mathrm{top}}\]上die翻转后,其金属层在统一stack中的顺序也随之反转。除了重新编号金属层,还需要同步映射cell pin所属层、routing obstruction和via连接关系,并相应映射各层的pitch、preferred direction、设计规则与RC参数。
统一metal stack设计引入了Metal Layer Sharing的可能性:一条net可以借用另一侧die的金属资源完成部分连接,甚至所有pin都位于同一die的net,也可能跨到另一侧走线后再返回。这样能够增加路径选择,但也会消耗额外的跨die连接,并改变RC寄生代价。这与3D Placement时通常简化考虑每个跨die net使用一个HBT的建模假设有所不同:实际routing中的HBT数量不一定等于cutsize,HBT的位置也可能会与布线拓扑共同变化。
3.2 3DIC Routing Flow
3D GP阶段我们讨论的是如何根据两个die的bbox求得HBT assign region,这一阶段的HBT位置考虑的是忽略资源竞争与布线障碍时,使D2D HPWL最小的几何区域。Co-Placement和合法化可以进一步得到满足位置、间距等约束的HBT,但这些位置仍主要由线长和密度代理指导。
实际上多个net的理想区域可能集中在同一局部;即使布局时可以解决理想HBT之间的间距违例,它们连接到两侧metal的路径仍可能竞争有限的tracks导致绕线失败。因此,相同的HBT数量并不对应相同的布线难度。HBT的局部分布、相对于metal pitch的尺寸,以及周围可用资源,都可能显著改变最终结果。
按照跨die连接位置与层内路径的主要决策顺序,我们将 3D Routing 分为 HBT-first 和 HBT-last :
3.2.1 HBT-first Routing
HBT-first 先确定合法的terminal位置,再将其作为两侧子网共享的固定端点,完成后续层内布线:
这个assignment可以发生在placement之后,也可以发生在Global Routing内部。提前确定HBT能够协调有限的跨die资源,并将后续问题拆成各die上的布线任务;代价是后续路径必须经过既定anchor,这在一定程度上缩小了搜索路径的解空间。这类方法的重点是如何在位置确定之前估计其对布线的影响。
- BTAssign:Routing-aware Legal Hybrid Bonding Terminal Assignment
BTAssign在placement之后、routing之前,为跨die nets分配合法terminal。算法首先构建满足HBT pitch要求的规则二维候选阵列(terminal mesh),再从这些离散位置中选择terminal并分配给各个net。一个net可以使用多个terminal,但每个候选位置最多只能分配给一个net。
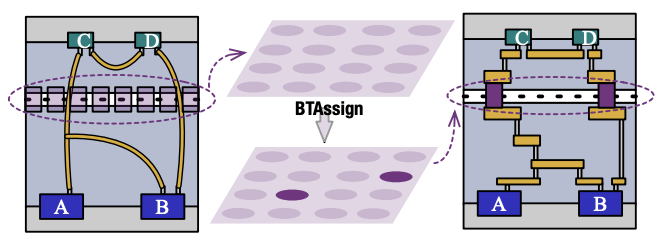
由此,terminal的几何合法性通过候选阵列保证,位置竞争则由assignment协调。BTAssign使用包含pins和已分配terminals的MST线长估计连接代价,使分配结果同时考虑后续布线需求。
算法通过四叉树划分问题,在局部区域内执行多轮二分图匹配,并随已有 assignment 更新后续选择的代价。其主要思路是:把多个net对合法terminal的竞争提前协调,同时让assignment尽量保留较好的连接拓扑。
后续工作 BTAssign-R 进一步引入 P-RUDY,根据跨die连接需求的空间分布指导候选位置和 assignment 代价,使terminal 分配能够避开需求集中的区域。
- H3D:Heterogeneous Resources Aware Global Router
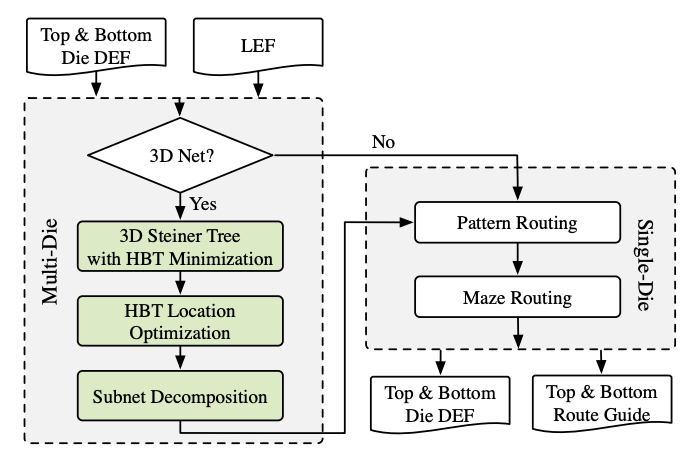
H3D在连线搜索之前,将连接拓扑与HBT资源约束结合起来完成terminal规划,之后层内绕线之间以已确定的HBT作为连接端点。
H3D在Global Routing的拓扑规划阶段先完成HBT决策。它首先将pins投影到平面,构建Steiner树,再通过动态规划确定树中各连接的die分配,以减少所需的HBT数量;随后在显式区分metal grid与HBT array的异构资源模型上,根据当前可用的合法位置,联合调整HBT及相关Steiner点的位置,以降低线长。确定合法HBT后,将net在HBT处拆成单die子网,再执行Pattern Routing和Maze Routing。
3.2.2 HBT-last Routing (Native 3D Routing)
HBT-last保留跨die连接位置的自由度,由router在搜索路径时共同决定两侧die的走线,terminal位置完全由routing算法探索确定,而不是给定预先计算好的HBT anchor。这种方式能够根据可用金属资源、障碍和拥塞选择跨die位置,也可以根据连接拓扑使用多个 terminal。相比提前固定anchor,它保留了更多路径选择,但也对 router 正确处理跨die资源的尺寸、间距、容量和接入规则的要求更高。
- Pin-3D: 利用成熟2D工具完成完整3D布线
成熟的2D布线器本来就能够处理多层金属和via。 如果将两个die的BEOL组织为统一metal stack,并把各侧cell pins映射到正确的金属层,router就可以在完整的连接关系上寻路,将跨die连接作为特定层之间的via transition处理。
Pin-3D类流程中,COVER视图可用于管理逐die优化中的上下映射:在保留逻辑连接的同时,使非活动die的cell不按当前die的普通可放置对象参与优化。布线阶段通过扩展metal stack,将HBT表示为特殊via,使router能够在统一资源视图中建立跨die连接。
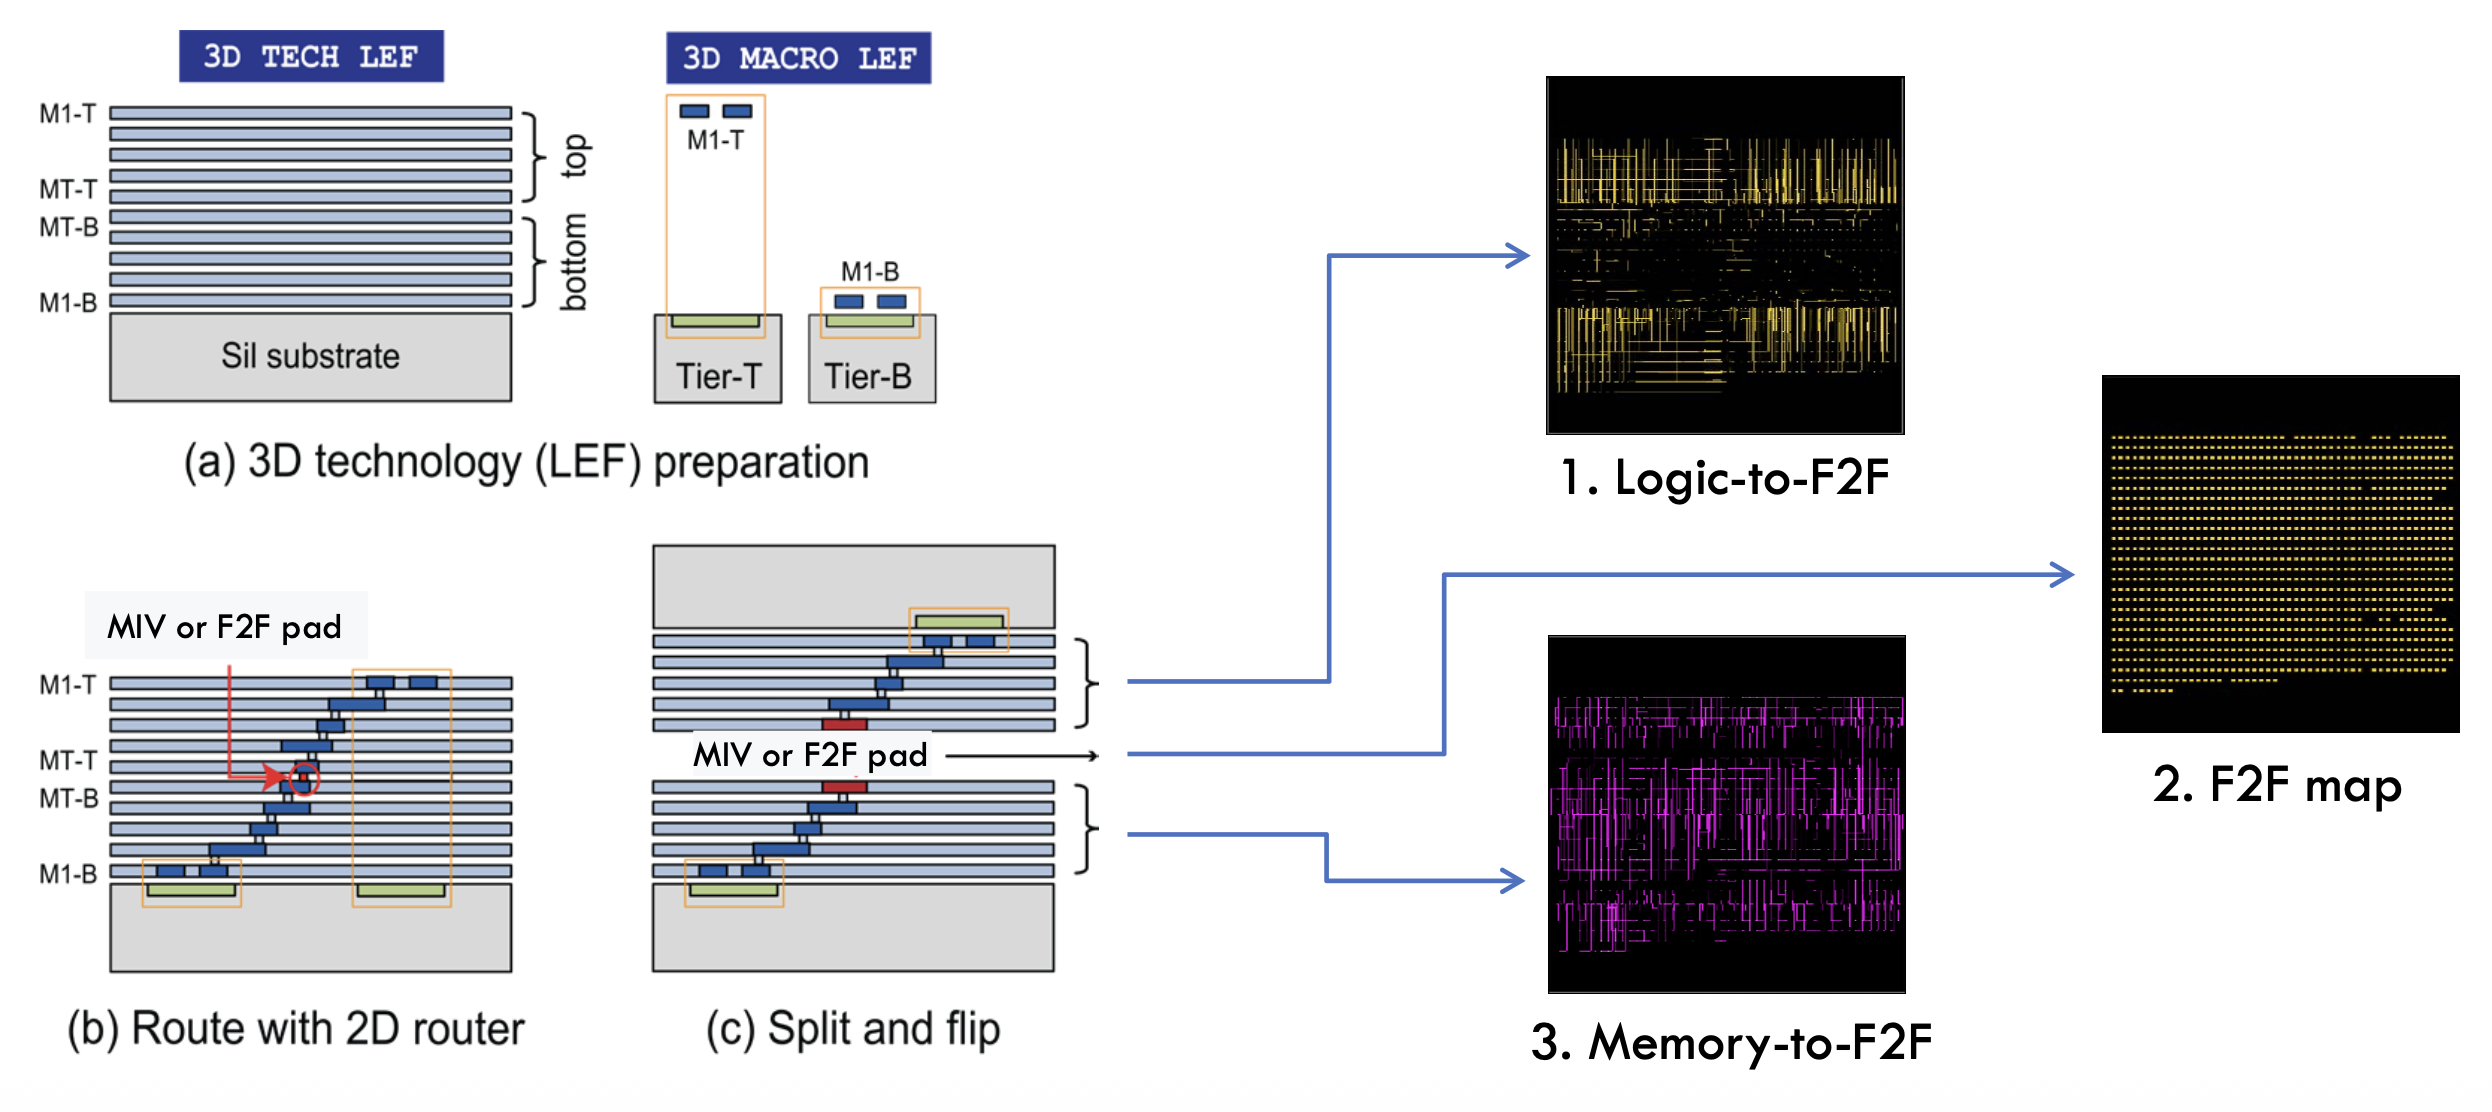
但当跨die资源直接参与路径搜索时,工具内部的算法设置是否对3D问题原生支持也会更加明显地影响布线结果。这里我们主要讨论的是F2F情况下的3D Routing与Pin-3D设计的原生适配问题:
-
镜像metal stack下的pin access方向与绕线层选择。 F2F映射后的upper层与常规的metal stack镜像相反。原生实现中仅支持向上的pin access处理逻辑,无法正确处理upper-tier pin所需的向下接入。同时upper层的金属层选择顺序也需要在算法层面逆向重排。
-
HBT与metal层间尺度异构。 HBT cut与相邻metal的尺寸、pitch差距较大。如果默认GCell、routing guide未能正确表达这些约束,Rip-up and Re-route可能在Clip内反复搜索无法合法实现的连接,在HBT附近持续产生violation无法解决。
开源工具可以通过修改适配的算法设置、更改GCell大小、引入HBT辅助metal层等方法改善3D Routing的收敛,这些改造使3D metal stack能够直接被现有router处理。
如此得到的统一metal stack也为metal layer sharing提供了利用条件。 Net的走线可以使用两个die的金属资源;即使全部pin都位于同一die,也可以跨到另一侧完成部分走线,再返回原die。这使router能够利用另一侧较空闲的金属层,缓解局部拥塞,更充分地使用整个stack的布线资源。
需要注意的是:Metal Layer Sharing可以缓解拥塞,但也可能增加HBT数量和跨die往返资源。若代价函数只关注线长或拥塞,而没有充分考虑两侧BEOL、via和HBT的完整RC,就可能得到更容易布通、但时序收益有限甚至退化的结果。更完善的3D布线算法需要对完整跨die路径进行RC建模,并在路径选择中权衡拥塞改善与新增的时序代价。
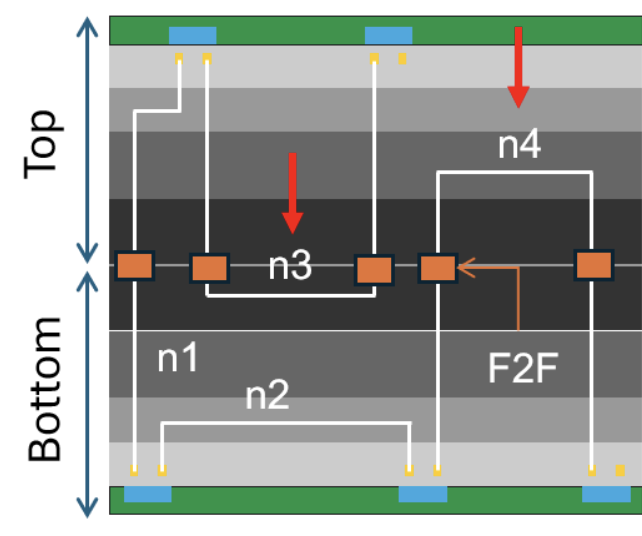
四、LogicFolding 局限和挑战
3D集成提供了在垂直方向组织电路的能力,但不同设计利用这一能力的层次和目标并不相同。AMD 3D V-Cache通过缓存与计算die的堆叠扩展L3缓存容量;Intel Foveros为不同功能和工艺die的堆叠进行异构集成;本文关注的LogicFolding则进一步调整逻辑模块内部的分层与物理连接组织,希望通过空间重组缩短关键互连。这些实例分别涉及产品组织、集成平台和逻辑优化方法,也对应不同的设计自由度与实现要求。
3D布局布线算法,为LogicFolding提供了求解方法。但布局阶段获得更优的HPWL,并不保证经过CTS和routing等下游步骤后仍能保留相同优势;routing完成也不保证时序约束和设计规则收敛。热与供电分析还可能要求重新调整空间分布,使分层、布局和布线需要继续迭代。跨die连接的容量与接入成本、工具内部的实现假设,以及后续时序和物理评估流程,都会限制哪些逻辑适合折叠、能够折叠到什么程度。因此,评估LogicFolding的工程价值需要同时考察算法获得的收益,以及支撑这些收益的实现条件。
4.1 F2F vs. F2B
F2F与F2B不仅改变die的朝向,也改变cell与各层metal之间的相对位置。即使采用相同的逻辑分区和金属层数量,两种结构中的接入路径与资源使用方式也可能明显不同。而Metal Layer Sharing的收益取决于die借用哪些金属层,以及为此增加了多少连接代价。
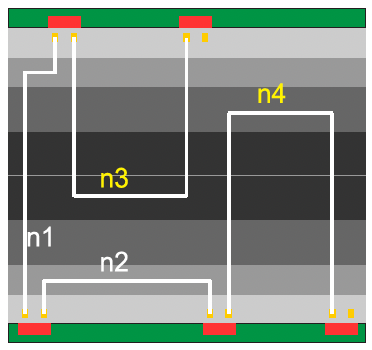
- F2F:两侧高层metal相邻,MLS需要经过本侧BEOL。 两个die的最高metal层在bonding interface处相邻,而cell位于整个stack的两端。一个die上的net需要先经过自身BEOL,才能借用另一侧的高层metal。在两侧工艺和stack相近时,这种接入关系较为对称,但共享需求主要来自需要使用高层metal的长连接。对于连接两侧cell的跨die net,路径还需要经过两套BEOL,因此HBT本身的RC只占完整连接代价的一部分。
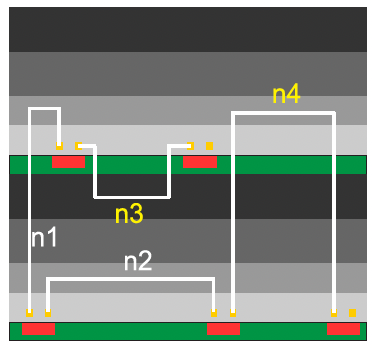
- F2B:上die更容易借用下die的高层metal,MLS具有明显的选择方向性。 在论文采用的F2B结构中,上die的器件层靠近下die的最高metal层,使上die的net能够通过较短的接入路径,借用下die较空闲、适合长距离走线的高层metal。反向共享则需要经过更长路径,并受到上die低层布线、cell及垂直互连合法位置的限制。因此,当下die存在较多空闲高层metal时,F2B更容易缓解上die的布线压力,但两个die并不是对等地共享金属层资源。
更多MLS也会增加跨die连接。对于所有pin都位于同一die的net,借用另一侧metal后还需要返回,至少产生两次跨die连接;界面两侧阻塞分布不同时,同一net还可能在寻路过程中反复跨越界面。MLS能够改善部分关键路径,却不保证整体PPA同时受益。这些结果还依赖具体的垂直互连工艺。当互连pitch增大时,合法接入位置减少,与cell及周围metal的资源竞争也会加剧。采用TSV或其他背面连接结构时,还需要重新考虑互连长度、面积占用和接入约束。堆叠方式还会使两个die的布局与供电发生额外耦合。例如:上die的macro及其blockage可能阻挡通往下die macro的垂直接入,使信号被迫沿窄通道绕行,供电也难以直接覆盖被遮挡区域。甚至可能需要新增额外的高层metal,用于供电分布。因此,LogicFolding的堆叠选择需要结合跨die接入、供电等复杂约束,判断金属共享带来的布线收益能否转化为最终的PPA改善。
4.2 Gate-level vs. Block-level
Gate-level与Block-level分层的主要区别,在于跨die优化所允许改变的设计范围。Gate-level允许同一模块中的cell分布在不同die,为缩短模块内部及模块之间的互连提供更大的联合优化空间。Block-level则以模块为单位确定die归属,限制模块内部cell跨die迁移,但并不意味着模块的物理实现完全固定。对于soft block,仍可以调整其面积、形状和内部布局,并在保留模块边界的条件下执行后续优化。
更细粒度的自由度,需要相应的跨die互连资源支撑。随着工艺节点缩小,cell面积和设计footprint可以显著下降,但hybrid bonding pitch未必同比缩小,使单位逻辑规模可获得的HBT资源减少。Gate-level分层可能将大量模块内部连接转化为跨die连接,其线长收益因而受到HBT容量、局部接入和布线拥塞的约束。Block-level将模块内部逻辑保留在同一die,有助于降低这部分跨die需求。
Block-level的模块边界限制了cell的全局移动,模块内部与模块之间的优化相对分离,可能错失跨模块关键路径的优化机会。模块尺寸和布局密度还会影响最终收益:过于紧凑的block虽然缩短了模块间距离,却可能加剧内部拥塞,导致布线绕行和时序恶化。
而Gate-level的设计自由度能否完全转化为实际收益,需要取决于跨die资源是否能够承接新增连接。仅满足各die的cell面积或密度约束,并不足以说明细粒度分层具有物理可行性。异构工艺也进一步限制了cell的换层调优的自由度。Macro、具有特定要求的逻辑,也不能像普通标准单元一样自由迁移。因此,如何根据互连瓶颈选择分层粒度也是需要反复验证的重要决策。
4.3 学术Flow vs. 商业工具
LogicFolding的实际收益,需要在完整的物理实现与验证流程中检验。复用成熟2D工具,为构建可复现的学术3D评估流程提供了一条可行路径,但如此构建的学术流程缺少与目标3D堆叠匹配的QRC及签核配置。近似RC可以支持给定假设下的算法比较,但难以据此确定目标工艺中的实际收益。因此,学术flow中的布线收敛及其PPA结果和真实工艺下的设计收敛还有很大差距。
Integrity 3D-IC、3DIC Compiler已经提供多die协同优化和跨die分析。3Dblox所采用的描述层次也主要围绕chiplet、die、interposer等组件,描述其物理属性、堆叠关系和组件间连接,适合支持多die系统的集成与工具协同。而更细粒度Native 3D优化将die内部的cell归属和跨die物理连接也纳入求解过程而3Dblox本身并不定义这些操作表示。将学术结果转换为各die独立的实现数据库后,如果必须重新分配接口或调整布线策略,后续评估就可能不再对应原来的优化结果。因此,采用统一的系统描述标准之后,仍需额外建立逻辑划分、坐标变换、工艺层、HBT和寄生网络之间的一致映射,才能将学术优化结果交由商业工具进行更准确的分析。